Repelling-Attracting
Hamiltonian Monte Carlo
Siddharth Vishwanath
Based on joint work with:
Hyungsuk Tak
The problem with diffusions
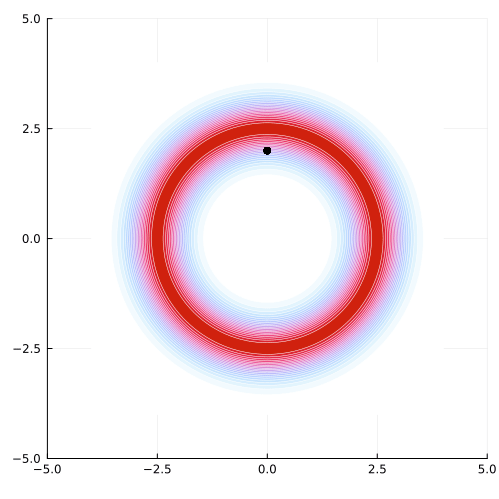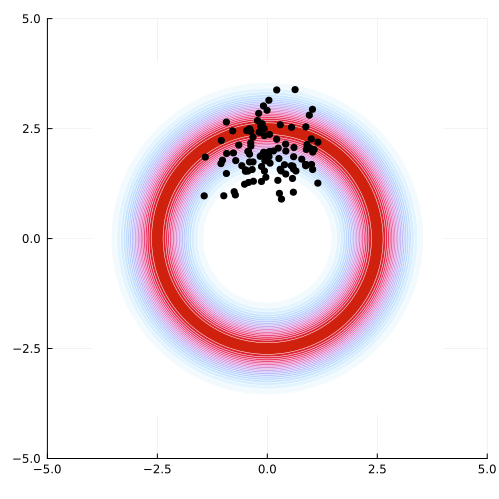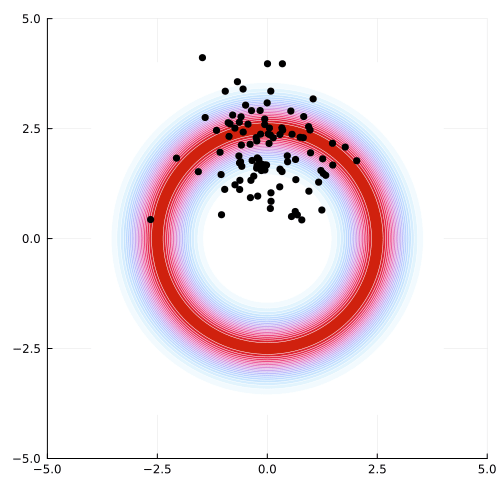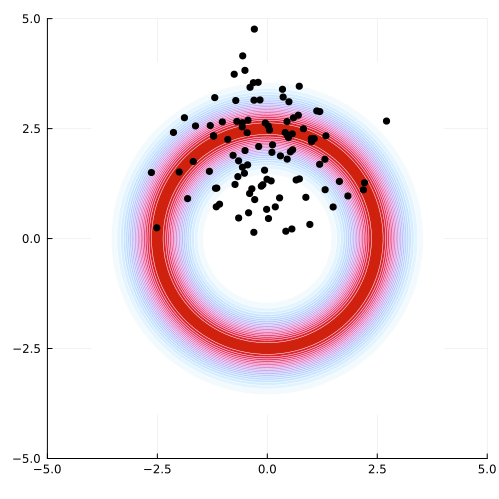
Wastes too much time in high dimensions.
Random Walk Metropolis.
- Given current state \(\boldsymbol{q}\sim \pi\)
- Generate \[ \boldsymbol{q}' \sim \varphi(\boldsymbol{q}' -\boldsymbol{q}) \]
- Accept/Reject the proposed state with probability \[ \alpha(\boldsymbol{q}', \boldsymbol{q}) = \frac{\varphi(\boldsymbol{q}-\boldsymbol{q}') \cdot e^{-U(\boldsymbol{q}')}}{\varphi(\boldsymbol{q}'-\boldsymbol{q}) \cdot e^{-U(\boldsymbol{q})} } \]
Gradients provide useful information
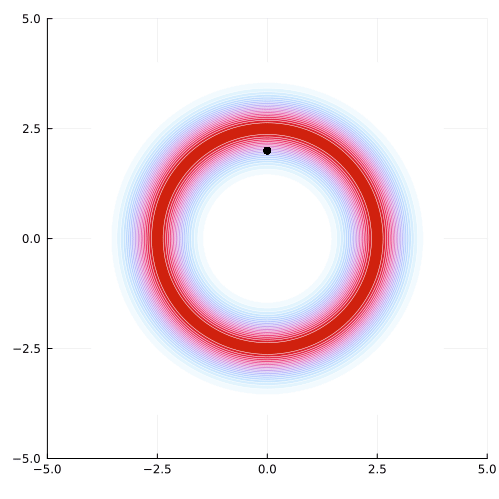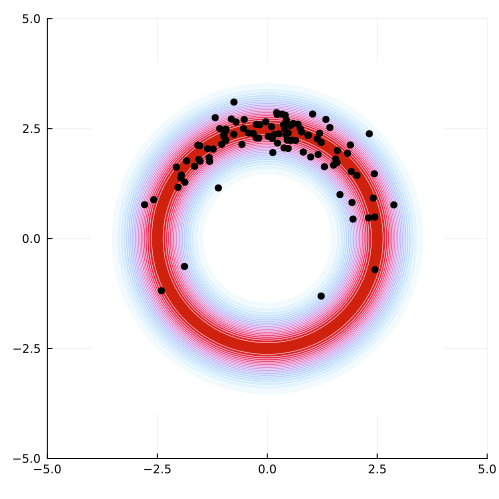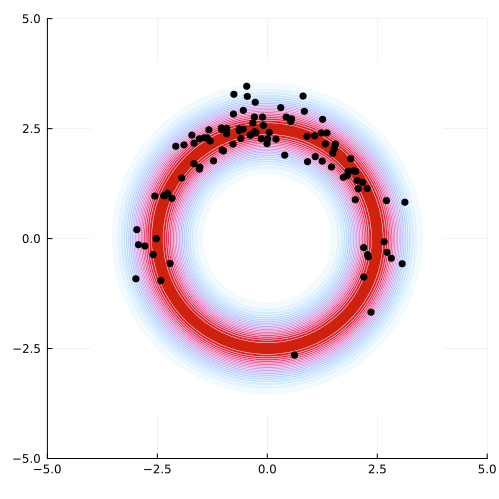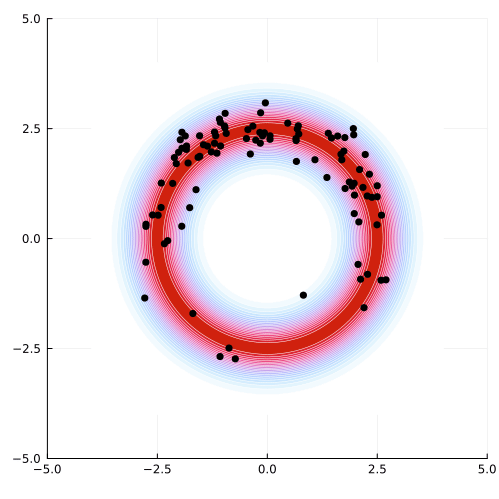
Metropolis-adjusted Langevin algorithm.
- Given current state \(\boldsymbol{q}\sim \pi\)
- Generate \[ \boldsymbol{q}' \sim q - {h} \cdot \boldsymbol{\nabla}U(\boldsymbol{q}) + \sqrt{2h}\!\cdot\!{\mathsf N}({\mathbf{0}}, {\mathbb I}_d) \]
- Accept/Reject the proposed state with probability \[ \alpha(\boldsymbol{q}', \boldsymbol{q}) = \frac{\phi_{2h}(\boldsymbol{q}- \boldsymbol{q}' - h \nabla U(\boldsymbol{q}')) \cdot e^{-U(\boldsymbol{q}')}}{\phi_{2h}(\boldsymbol{q}' - \boldsymbol{q}- h \nabla U(\boldsymbol{q})) \cdot e^{-U(\boldsymbol{q})} } \]
Only works well for small step sizes.
Hamiltonian Monte Carlo
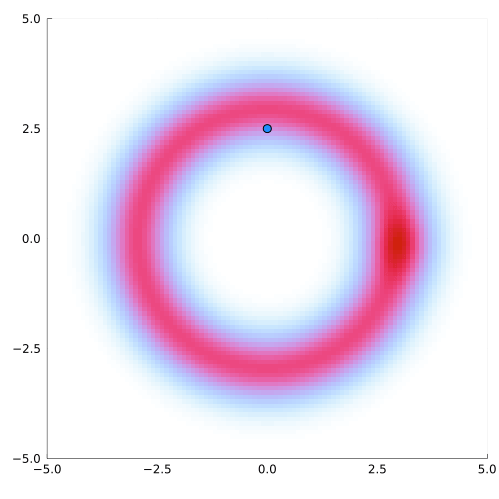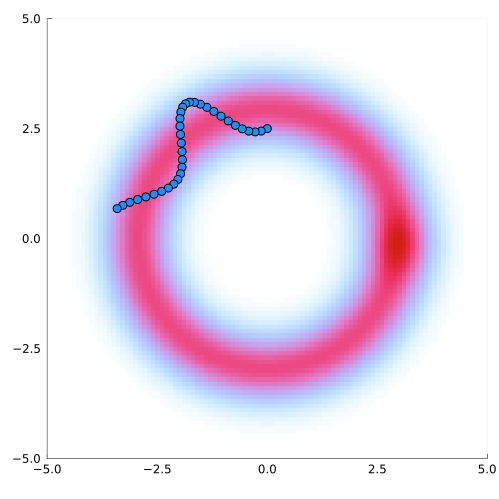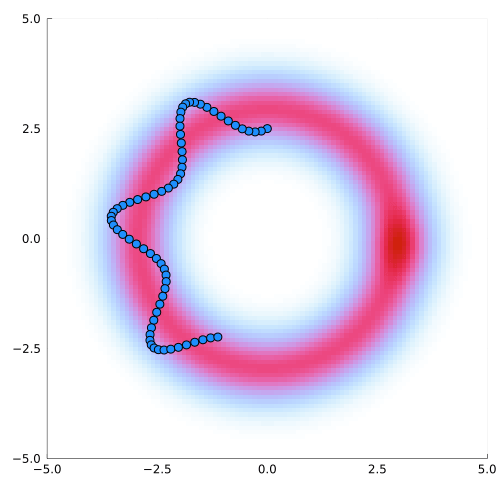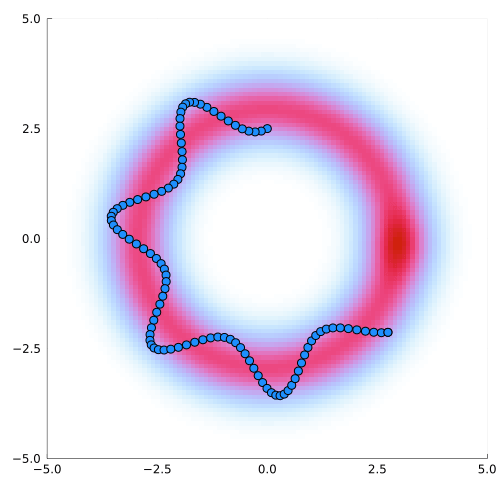
The four pillars of Hamiltonian Monte Carlo
Theorem (Arnold (2013))
Let \(\mathbf{F}: (\boldsymbol{q}, \boldsymbol{p}) \mapsto (\boldsymbol{q}, -\boldsymbol{p})\) denote the momentum flip and \({\boldsymbol{\Phi}}_t: (\boldsymbol{q}_0, \boldsymbol{p}_0) \mapsto (\boldsymbol{q}_t, \boldsymbol{p}_t)\) be the Hamiltonian flow
Then
\(\displaystyle\left(\mathbf{F}\circ {\boldsymbol{\Phi}}_t\right) \circ \left(\mathbf{F}\circ {\boldsymbol{\Phi}}_t\right) = \text{id}.\)
\((\boldsymbol{q}_t, \boldsymbol{p}_t) = \mathbf{F}\circ {\boldsymbol{\Phi}}_t(\boldsymbol{q}_0, \boldsymbol{p}_0)\)
and
\((\boldsymbol{q}_0, \boldsymbol{p}_o) = \mathbf{F}\circ {\boldsymbol{\Phi}}_t(\boldsymbol{q}_t, \boldsymbol{p}_t)\)
\[ \alpha(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0) = \frac{\enclose{horizontalstrike}[mathcolor="red"]{\kappa(\boldsymbol{q}_0, \boldsymbol{p}_0 | \boldsymbol{q}_t, \boldsymbol{p}_t)} \cdot {e^{-H(\boldsymbol{q}_t,\boldsymbol{p}_t)}}}{\enclose{horizontalstrike}[mathcolor="red"]{\kappa(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0)} \cdot {e^{-H(\boldsymbol{q}_0,\boldsymbol{p}_0)}}} \cdot \Bigg| {\frac{{\partial(\boldsymbol{q}_t, \boldsymbol{p}_t)}}{{\partial(\boldsymbol{q}_0, \boldsymbol{p}_0)}} \Bigg| } \]
Theorem (Arnold (2013))
For every trajectory \(\{(\boldsymbol{q}_t, \boldsymbol{p}_t) : t > 0\}\)
\[ \Bigg|\frac{\partial (\boldsymbol{q}_t, \boldsymbol{p}_t)}{\partial (\boldsymbol{q}_0, \boldsymbol{p}_0)}\Bigg| = \Bigg| \begin{bmatrix} \frac{\partial \boldsymbol{q}_0}{\partial \boldsymbol{q}_t} & \frac{\partial \boldsymbol{p}_0}{\partial \boldsymbol{q}_t} \\ \frac{\partial \boldsymbol{q}_0}{\partial \boldsymbol{p}_t} & \frac{\partial \boldsymbol{p}_0}{\partial \boldsymbol{p}_t} \end{bmatrix} \Bigg| = 1. \]

\[ \require{cancel} \require{enclose} \alpha(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0) = \frac{\enclose{horizontalstrike}{\kappa(\boldsymbol{q}_0, \boldsymbol{p}_0 | \boldsymbol{q}_t, \boldsymbol{p}_t)} \cdot {e^{-H(\boldsymbol{q}_t,\boldsymbol{p}_t)}}}{\enclose{horizontalstrike}{\kappa(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0)} \cdot {e^{-H(\boldsymbol{q}_0,\boldsymbol{p}_0)}}} \cdot \Bigg| {\frac{\enclose{horizontalstrike}[mathcolor="red"]{\partial(\boldsymbol{q}_t, \boldsymbol{p}_t)}}{\enclose{horizontalstrike}[mathcolor="red"]{\partial(\boldsymbol{q}_0, \boldsymbol{p}_0)}} \Bigg| } \]
Theorem (Arnold (2013))
For every trajectory \(\left\{(\boldsymbol{q}_t, \boldsymbol{p}_t) : t > 0\right\}\) satisfying the Hamiltonian dynamics
\(\displaystyle \frac{d}{d t}H(\boldsymbol{q}_t, \boldsymbol{p}_t) = 0.\)
\[ \alpha(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0) = \frac{\enclose{horizontalstrike}{\kappa(\boldsymbol{q}_0, \boldsymbol{p}_0 | \boldsymbol{q}_t, \boldsymbol{p}_t)} \cdot \enclose{horizontalstrike}[mathcolor="red"]{e^{-H(\boldsymbol{q}_t,\boldsymbol{p}_t)}}}{\enclose{horizontalstrike}{\kappa(\boldsymbol{q}_t, \boldsymbol{p}_t | \boldsymbol{q}_0, \boldsymbol{p}_0)} \cdot \enclose{horizontalstrike}[mathcolor="red"]{e^{-H(\boldsymbol{q}_0,\boldsymbol{p}_0)}}} \cdot \Bigg| {\frac{\enclose{horizontalstrike}{\partial(\boldsymbol{q}_t, \boldsymbol{p}_t)}}{\enclose{horizontalstrike}{\partial(\boldsymbol{q}_0, \boldsymbol{p}_0)}} \Bigg| } \]
Theorem (Arnold (2013))
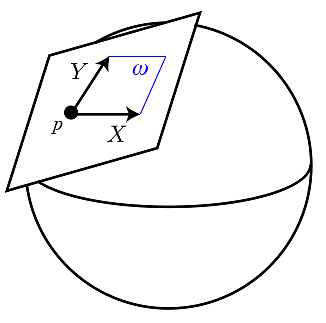
Let \(\omega(\cdot, \cdot)\) be the symplectic \(2\)-form \[ \omega(\boldsymbol{q},\boldsymbol{p}) = \sum_{i=1}^d dq_i \wedge dp_i. \]
Then \(\omega(\boldsymbol{q}_t, \boldsymbol{p}_t) = \omega(\boldsymbol{q}_0, \boldsymbol{p}_0)\) for all \(t \in {\mathbb R}\).
Why Symplectic Integration?
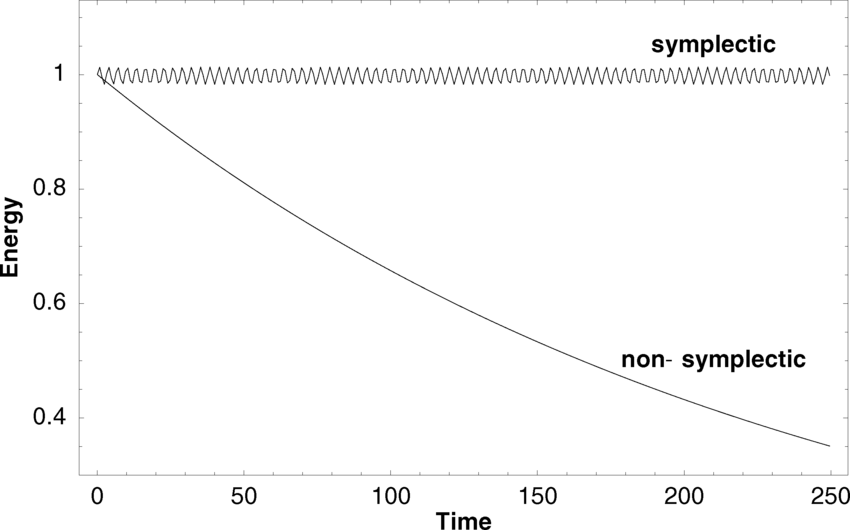
Theorem (Hairer, Lubich, and Wanner (2006)) \[ \big|H\left( {\boldsymbol{\Phi}}_{T}(\boldsymbol{q},\boldsymbol{p}) \right) - H\left( {\boldsymbol{\Phi}}_{\epsilon, L}(\boldsymbol{q},\boldsymbol{p}) \right)\big| \approx {O}(\epsilon^2). \] Therefore, \(\alpha(\boldsymbol{q}_T, \boldsymbol{p}_T | \boldsymbol{q}_0, \boldsymbol{p}_0) \gtrsim e^{-\epsilon^2}.\)
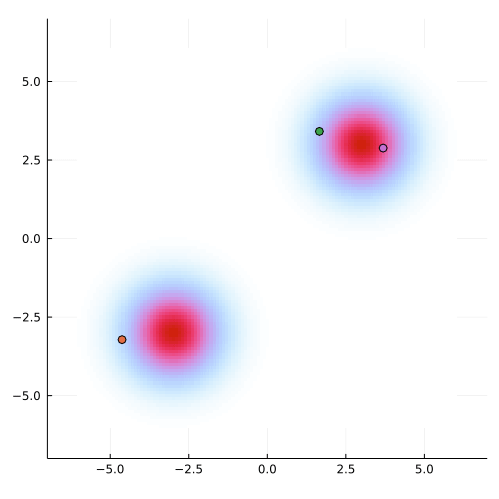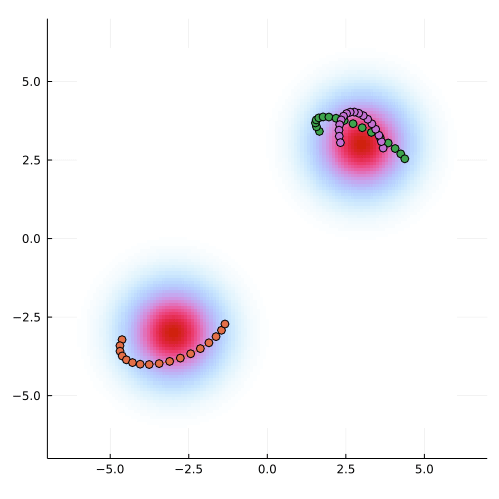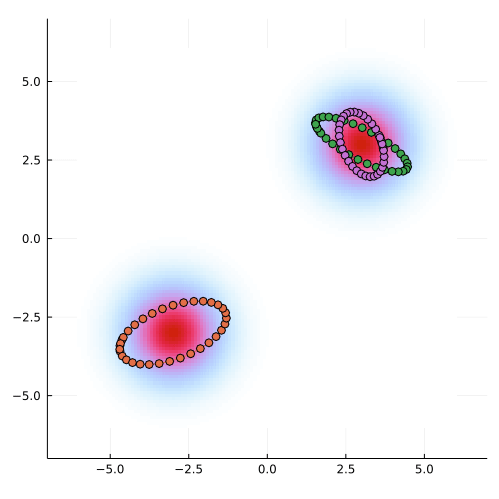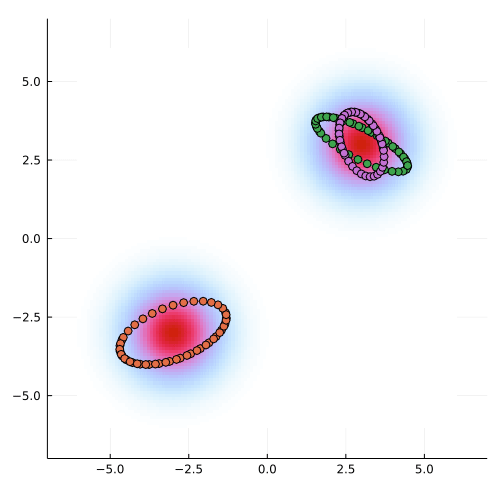
HMC + Multimodal
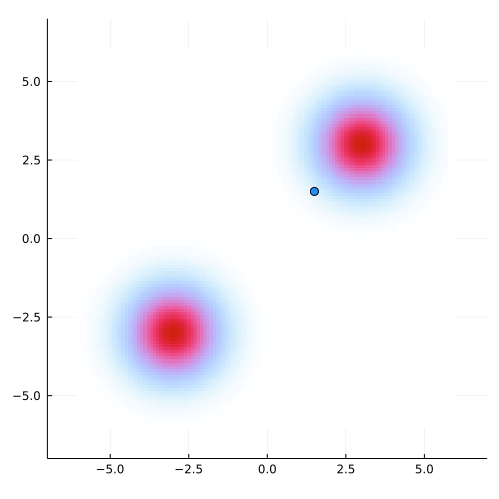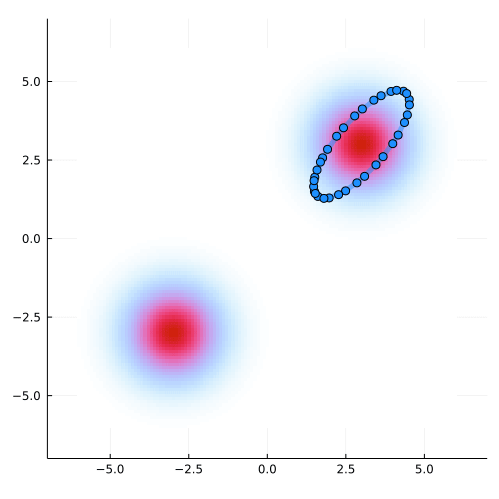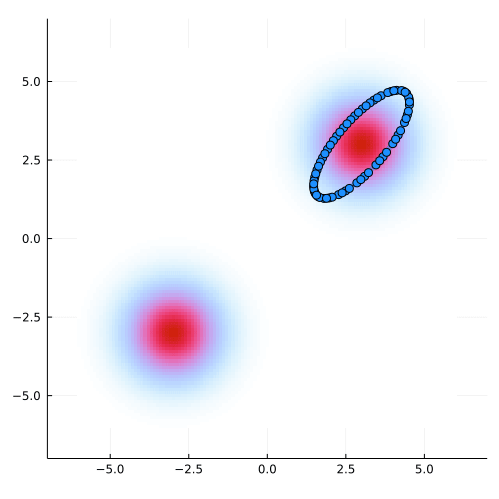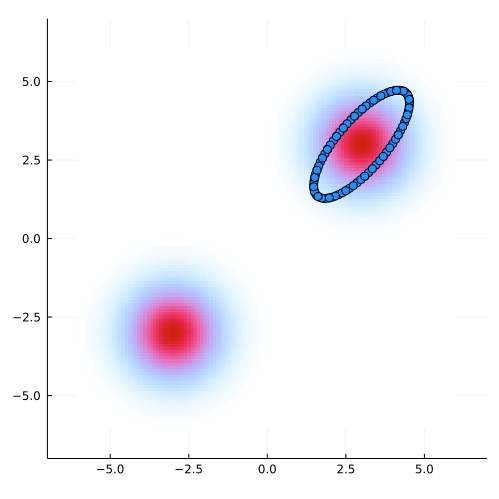
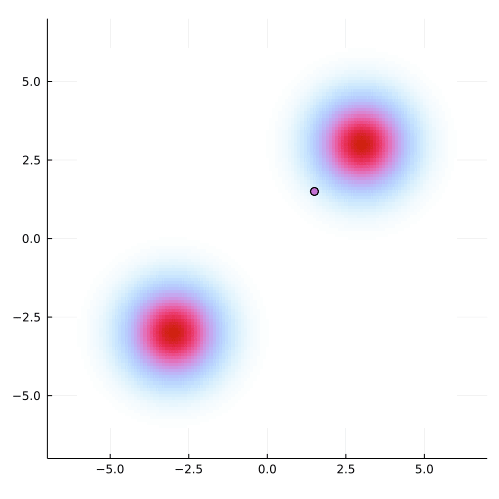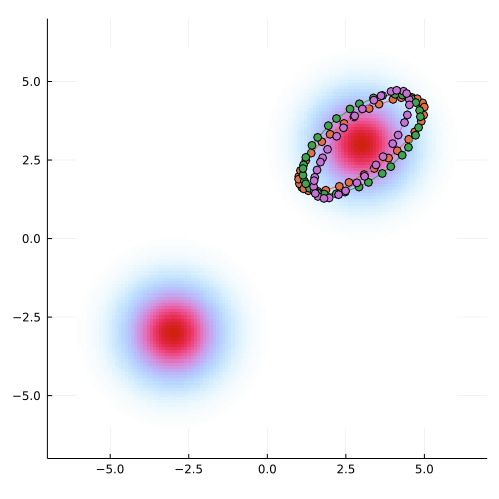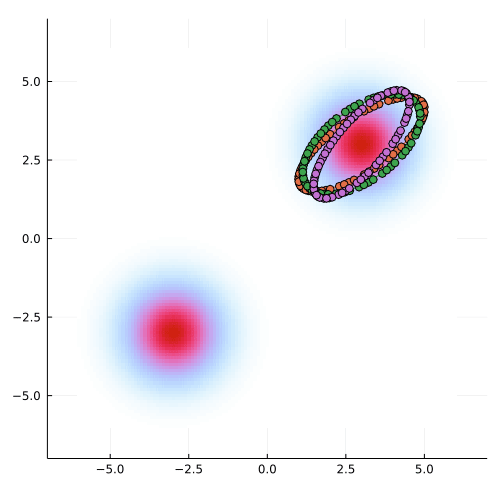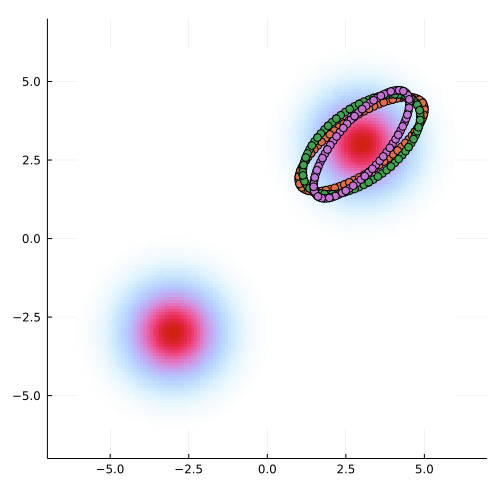
Observation #1: Friction \(\downarrow\) energy
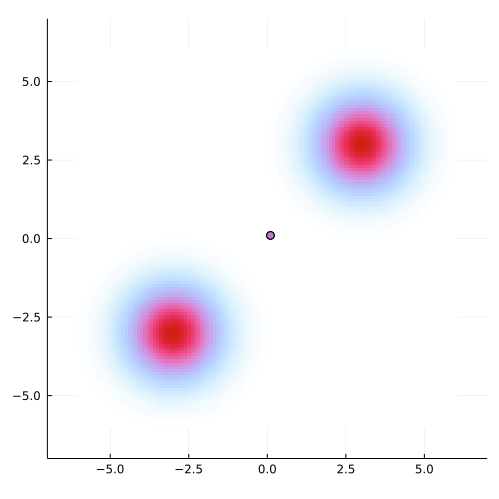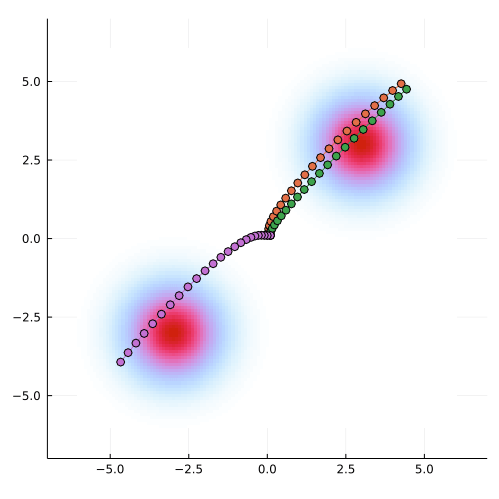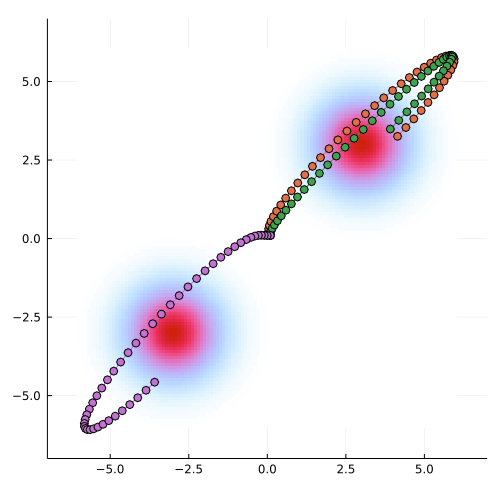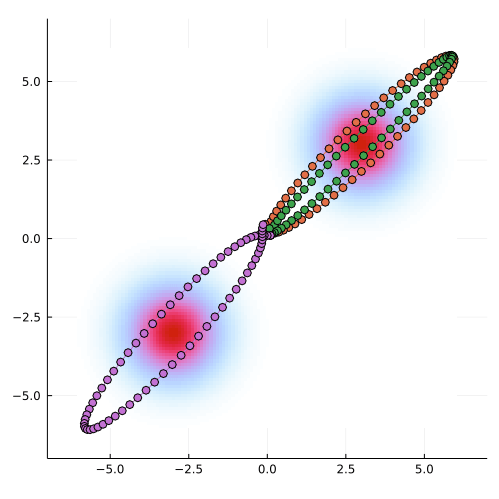
Without friction
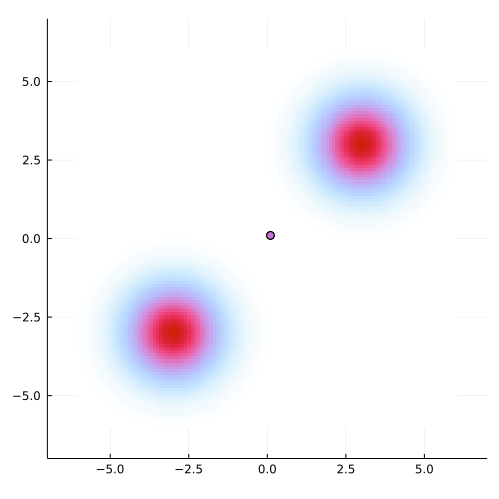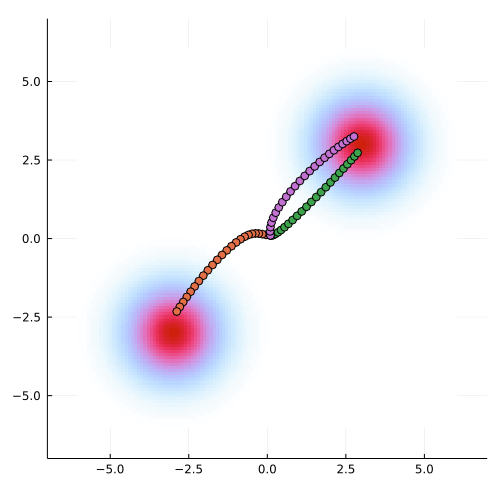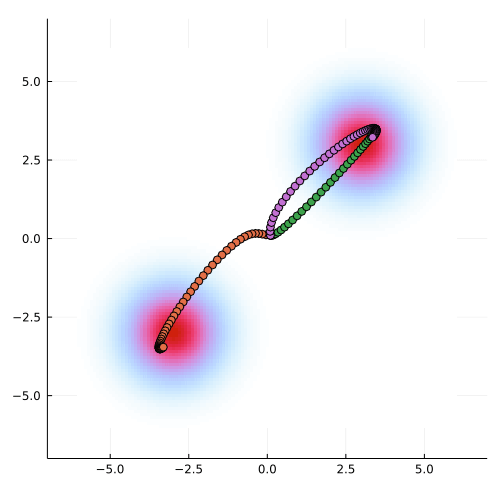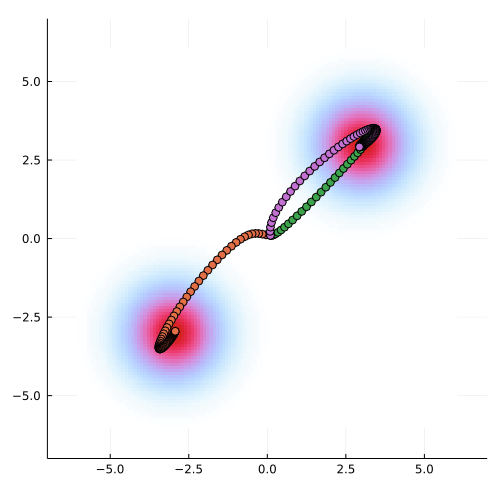
With friction
Observation #2: Negative friction \(\uparrow\) energy
Without friction
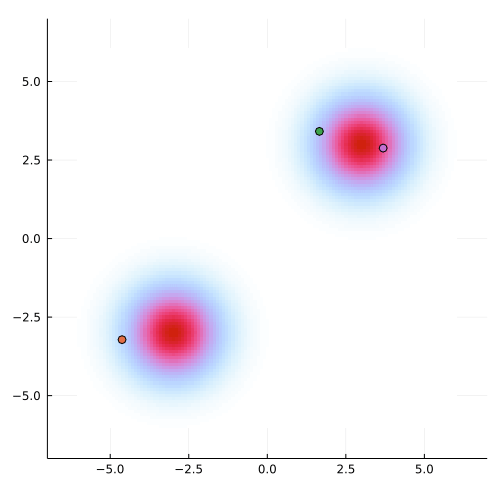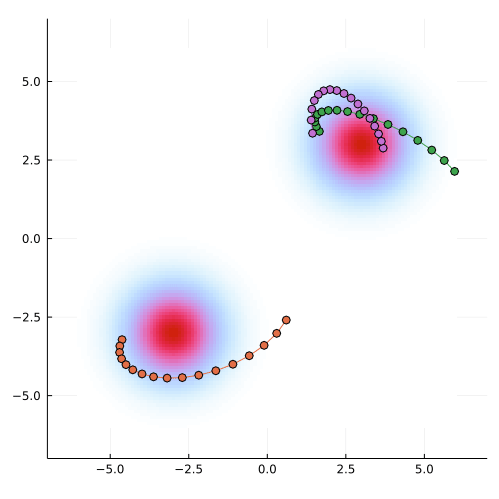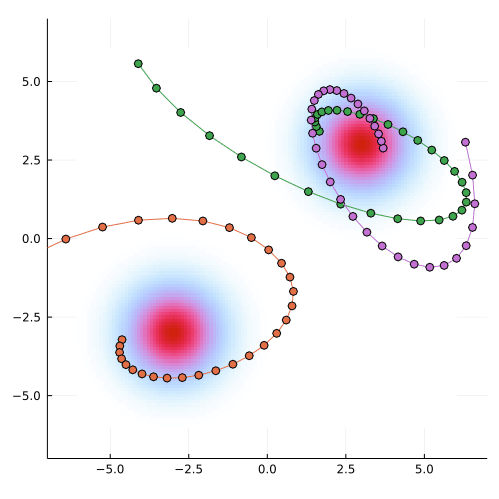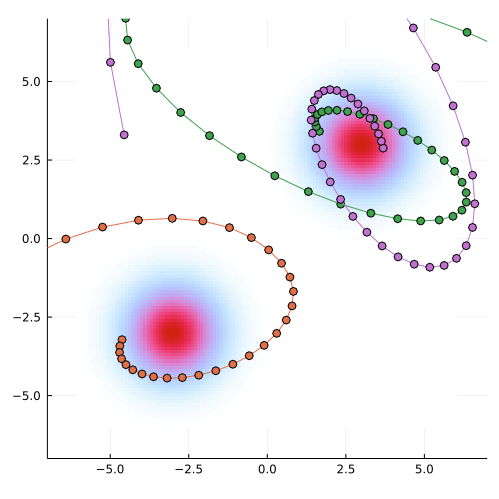
With negative friction
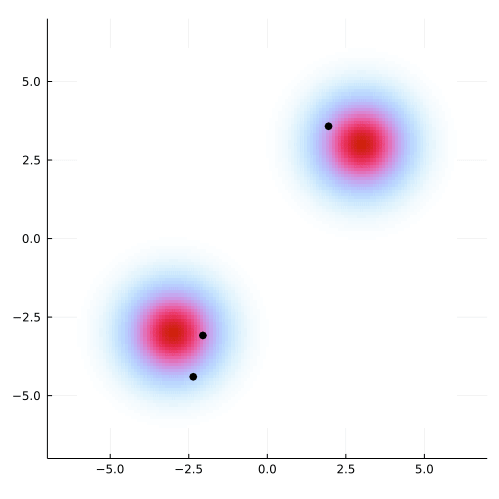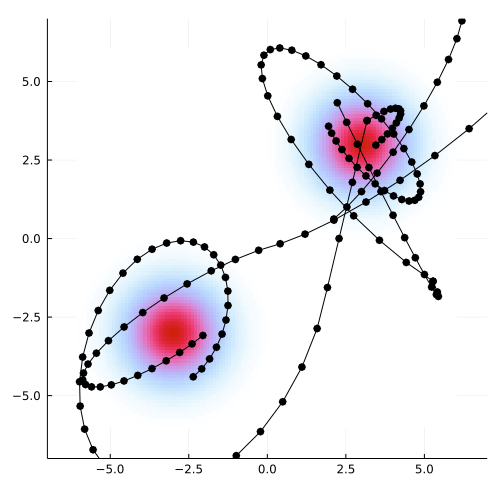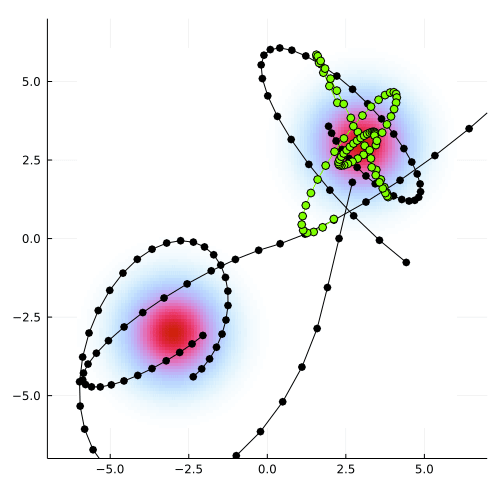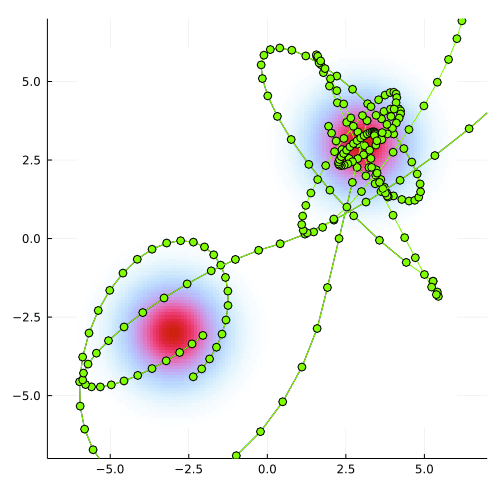
Repelling-Attracting HMC
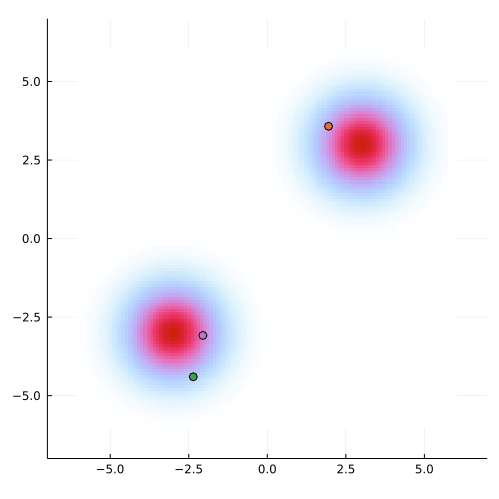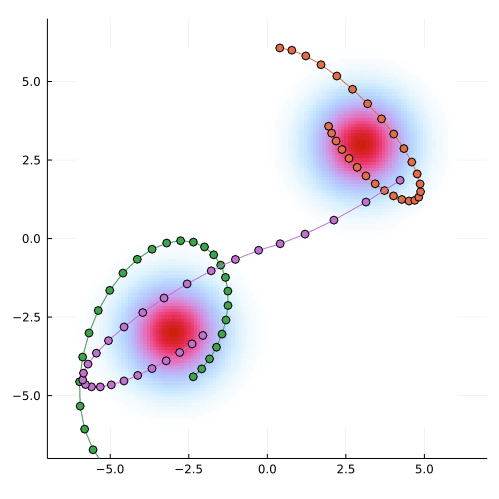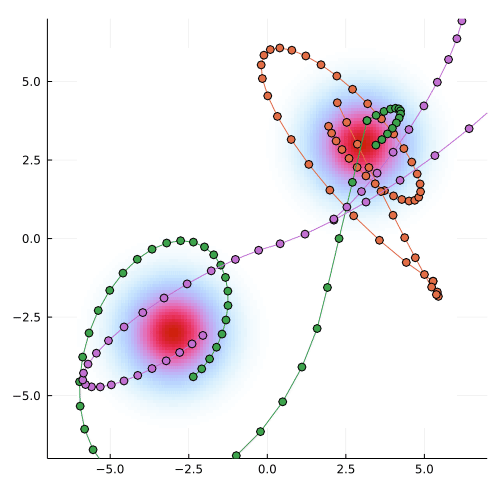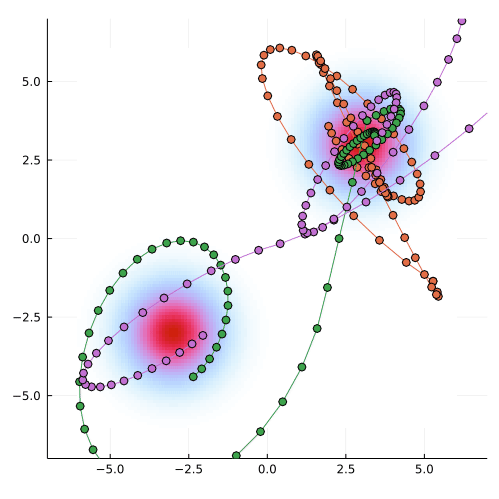
\(\color{dodgerblue}{{\boldsymbol{\Psi}}_T} = \color{red}{\boldsymbol{\Phi}^{-}_{T/2}} \circ \color{green}{\boldsymbol{\Phi}^{+}_{T/2}}\)
Repelling-Attracting HMC
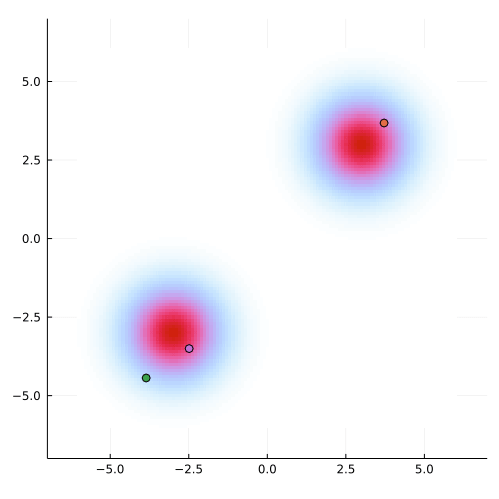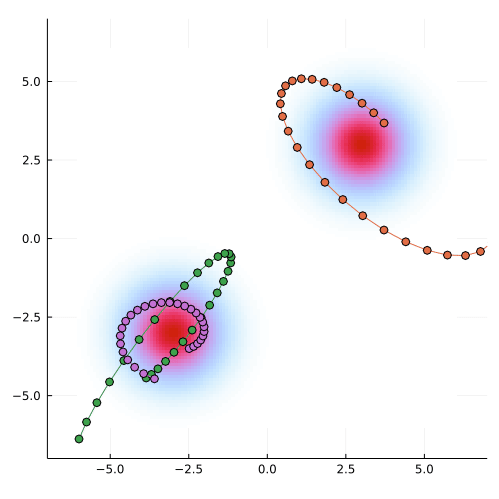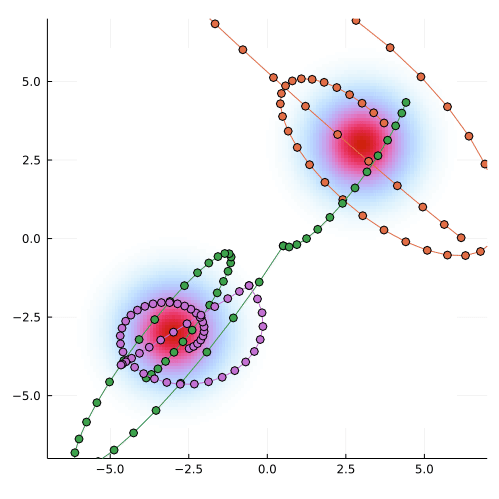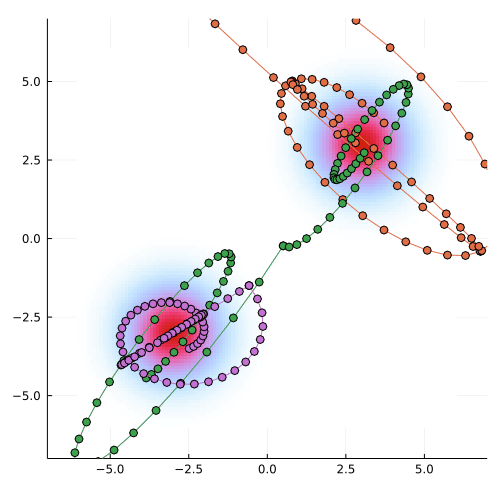
\(\color{dodgerblue}{{\boldsymbol{\Psi}}_T} = \color{red}{\boldsymbol{\Phi}^{-}_{T/2}} \circ \color{green}{\boldsymbol{\Phi}^{+}_{T/2}}\)
Properties of RA-HMC
Proposition (SV and Tak (2024))
- \(\mathbf{F}: (\boldsymbol{q}, \boldsymbol{p}) \to (\boldsymbol{q}, -\boldsymbol{p})\)
- \(\color{green}{\boldsymbol{\Phi}^{+}_t}\) and \(\color{red}{\boldsymbol{\Phi}^{-}_t}\) for the repelling-attracting dynamics
Then \[ \mathbf{F}\circ (\color{green}{\boldsymbol{\Phi}^{+}_t})^{-1} = \color{red}{\boldsymbol{\Phi}^{-}_t} \circ \mathbf{F} \]
In particular, for \({\boldsymbol{\Psi}}_{2t} = \color{red}{\boldsymbol{\Phi}^{-}_t} \circ \color{green}{\boldsymbol{\Phi}^{+}_t}\) \[ \big(\mathbf{F}\circ {\boldsymbol{\Psi}}_{2t}\big) \circ \big(\mathbf{F}\circ {\boldsymbol{\Psi}}_{2t}\big) = \text{id}. \]
Proposition (SV and Tak (2024))
\[ \bigg| \frac{\partial (\boldsymbol{q}_t, \boldsymbol{p}_t)}{\partial (\boldsymbol{q}_0, \boldsymbol{p}_0)} \bigg| = \begin{cases} > 1 & \text{ for }0 \le t \le T/2\\[5pt] < 1 & \text{ for }T/2 \le t \le T \end{cases} \]
In particular \[ \bigg| \frac{\partial (\boldsymbol{q}_t, \boldsymbol{p}_t)}{\partial (\boldsymbol{q}_T, \boldsymbol{p}_T)} \bigg| = 1. \]
\[ \alpha(\boldsymbol{q}_T, \boldsymbol{p}_T | \boldsymbol{q}_0, \boldsymbol{p}_0) = \frac{e^{-H(\boldsymbol{q}_T, \boldsymbol{p}_T)}}{e^{-H(\boldsymbol{q}_0, \boldsymbol{p})}} \]
Proposition (SV and Tak (2024))
The deformation of the symplectic 2-form is given by \[ \omega(\boldsymbol{q}_t, \boldsymbol{p}_t) = \begin{cases} e^{\gamma t} \cdot \omega(\boldsymbol{q}_0, \boldsymbol{p}_0), & 0 \le t \le T/2\\ \\ e^{\gamma (T-t)} \cdot \omega(\boldsymbol{q}_0, \boldsymbol{p}_0), & T/2 \le t \le T \end{cases}. \]
In particular, RA-HMC preserves the symplectic 2-form: \[\omega(\boldsymbol{q}_T, \boldsymbol{p}_T) = \omega(\boldsymbol{q}_0, \boldsymbol{p}_0).\]
Let \(\epsilon\approx dt\) the conformal symplectic leapfrog (França et al. (2020)) for \(\boldsymbol{\Phi}^{+}_\epsilon\approx \boldsymbol{\Phi}^{+}_{dt}\) is:
\[ \boldsymbol{\Phi}^{+}_\epsilon(\boldsymbol{q}_t, \boldsymbol{p}_t) = \begin{cases} {\widetilde{\boldsymbol{p}}}_{t+\frac\epsilon 2} \leftarrow e^{\gamma\epsilon/2}\boldsymbol{p}_t \\[2pt] \boldsymbol{p}_{t+\frac\epsilon 2} \leftarrow {\widetilde{\boldsymbol{p}}}_{t+\frac\epsilon 2} - \frac\epsilon 2 \boldsymbol{\nabla}U(\boldsymbol{q}_t) \\[2pt] \boldsymbol{q}_{t+\epsilon} \leftarrow \boldsymbol{q}_t + \epsilon\Sigma^{-1}{\widetilde{\boldsymbol{p}}}_{t+\frac\epsilon 2}\\[2pt] {\widetilde{\boldsymbol{p}}}_{t+\epsilon} \leftarrow {\widetilde{\boldsymbol{p}}}_{t+\frac\epsilon 2} - \frac\epsilon 2 \boldsymbol{\nabla}U(\boldsymbol{q}_{t+\epsilon})\\[2pt] \boldsymbol{p}_{t+\epsilon} \leftarrow e^{\gamma\epsilon/2}\boldsymbol{p}_{t+\epsilon} \end{cases} \]
Mutatis mutandis for \(\boldsymbol{\Phi}^{-}_e\). Finally, for \(L\) steps \({\boldsymbol{\Psi}}_{\epsilon, L} = (\boldsymbol{\Phi}^{-}_\epsilon)^{\otimes L/2} \circ (\boldsymbol{\Phi}^{+}_\epsilon)^{\otimes L/2}\).
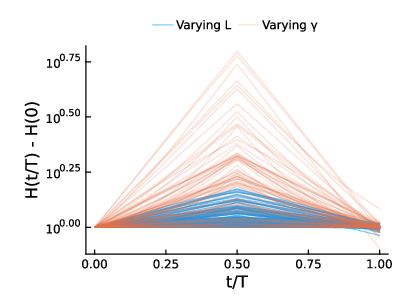
Proposition (SV and Tak (2024)) \(\quad \quad \big| H(\boldsymbol{q}_T, \boldsymbol{p}_T) - H(\boldsymbol{q}_{\epsilon, L}, \boldsymbol{p}_{\epsilon, L}) \big| = O(\epsilon^2)\).
Proposition (SV and Tak (2024))
Under some conditions on \(U(\boldsymbol{q}) = -\log(\pi(\boldsymbol{q}))\) and for \(\mathscr{C} = \big\{\boldsymbol{q}: \nabla U(\boldsymbol{q}) = 0\big\}\),
\[ \Big|{H({\boldsymbol{\Psi}}_T(\boldsymbol{q}, \boldsymbol{p})) - H(\boldsymbol{q}, \boldsymbol{p})}\Big| \le \inf_{{\boldsymbol{u}}, {\boldsymbol{v}}\in \mathscr{C}} \Big| {2H(\boldsymbol{\Phi}^{+}_{T/2}(\boldsymbol{q},\boldsymbol{p})) - H({\boldsymbol{u}}) - H({\boldsymbol{v}})} \Big| \cdot e^{-\lambda T/2} \\ \quad\quad\quad\quad+ \sup_{{\boldsymbol{u}}, {\boldsymbol{v}}\in \mathscr{C}}\Big|{H({\boldsymbol{u}}) - H({\boldsymbol{v}})}\Big| \]
\(U(\boldsymbol{q})\) is strongly-convex \(\Longrightarrow\) \(\Big|{H({\boldsymbol{\Psi}}_T(\boldsymbol{q}, \boldsymbol{p})) - H(\boldsymbol{q}, \boldsymbol{p})}\Big| \le \text{const}\).
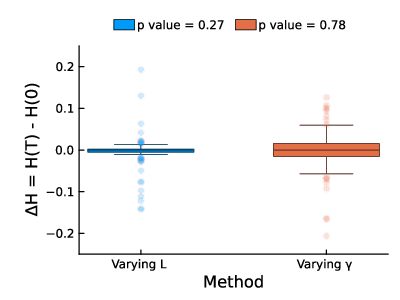
Energy drift
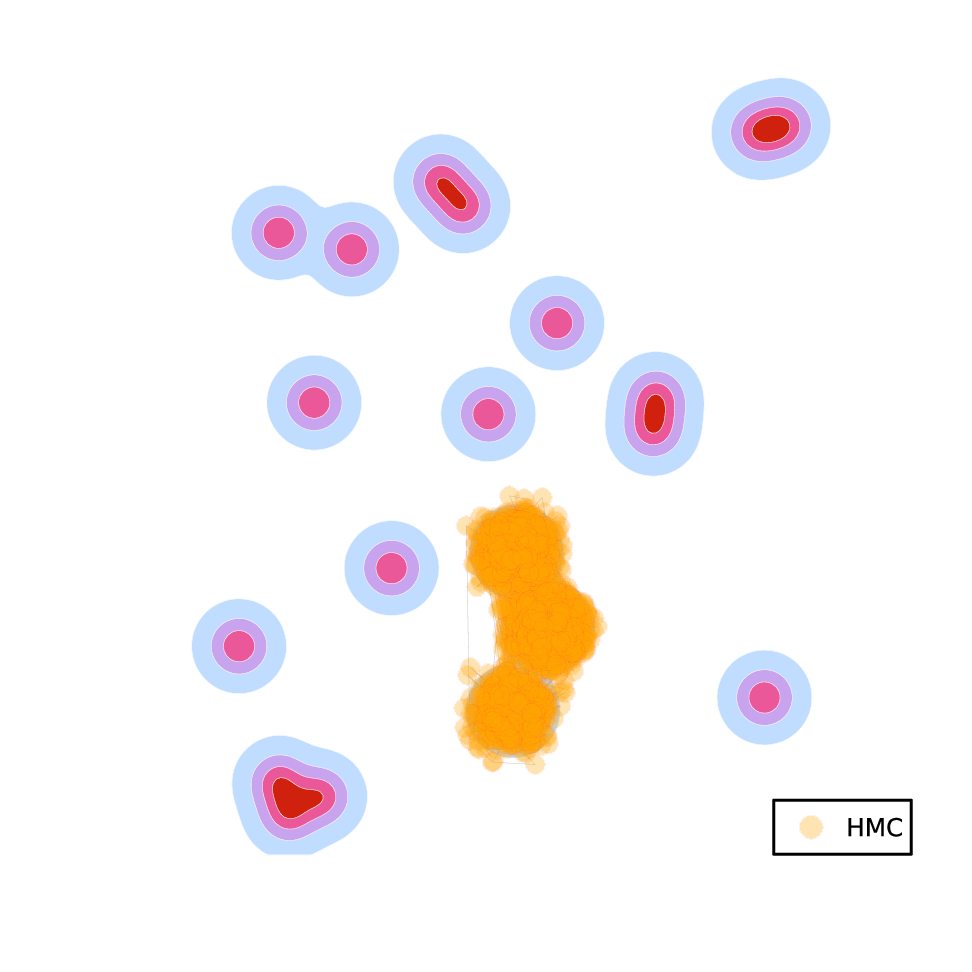
Benchmark data & Nested \(\ell_1\) target
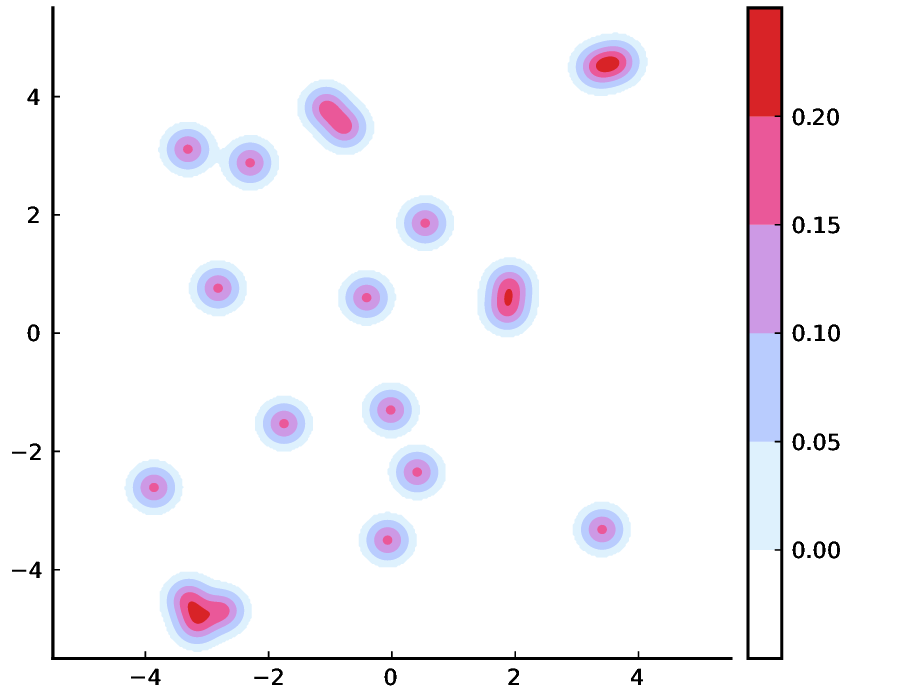
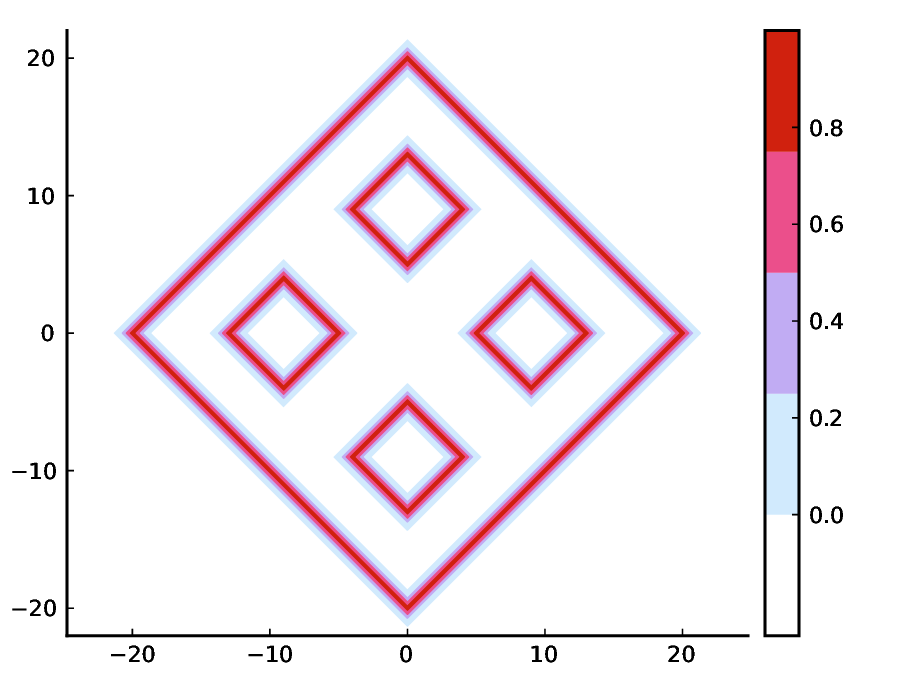
| Target | Method | \(W_2\) | Acceptance Rate | # Gradients per step (L) | CPU Time per iteration (Time /L) |
|---|---|---|---|---|---|
| Benchmark | HMC | 0.337 | 92.1% | 27 | 24.0s (0.9s) |
| RAHMC | 0.011 | 57.4% | 239 | 95.6s (0.4s) | |
| RAM* | 0.025 | 22.1% | NA | 1.8s (NA) | |
| PEHMC | 0.152 | 56.7% | 77 | 938.0s (13.4s) | |
| WHMC | 0.051 | 84.3% | 7 | 139.3s (19.9s) | |
| Nested \(\ell_1\) | HMC | 14.088 | 90.3% | 12 | 1.2s (0.1s) |
| RAHMC | 0.272 | 47.3% | 61 | 12.2s (0.2s) | |
| RAM* | 0.372 | 46.5% | NA | 12.4s (NA) | |
| PEHMC | 1.036 | 50.0% | 20 | 150s (7.5s) | |
| WHMC | 13.742 | 92.0% | 10 | 24.0s (2.4s) |
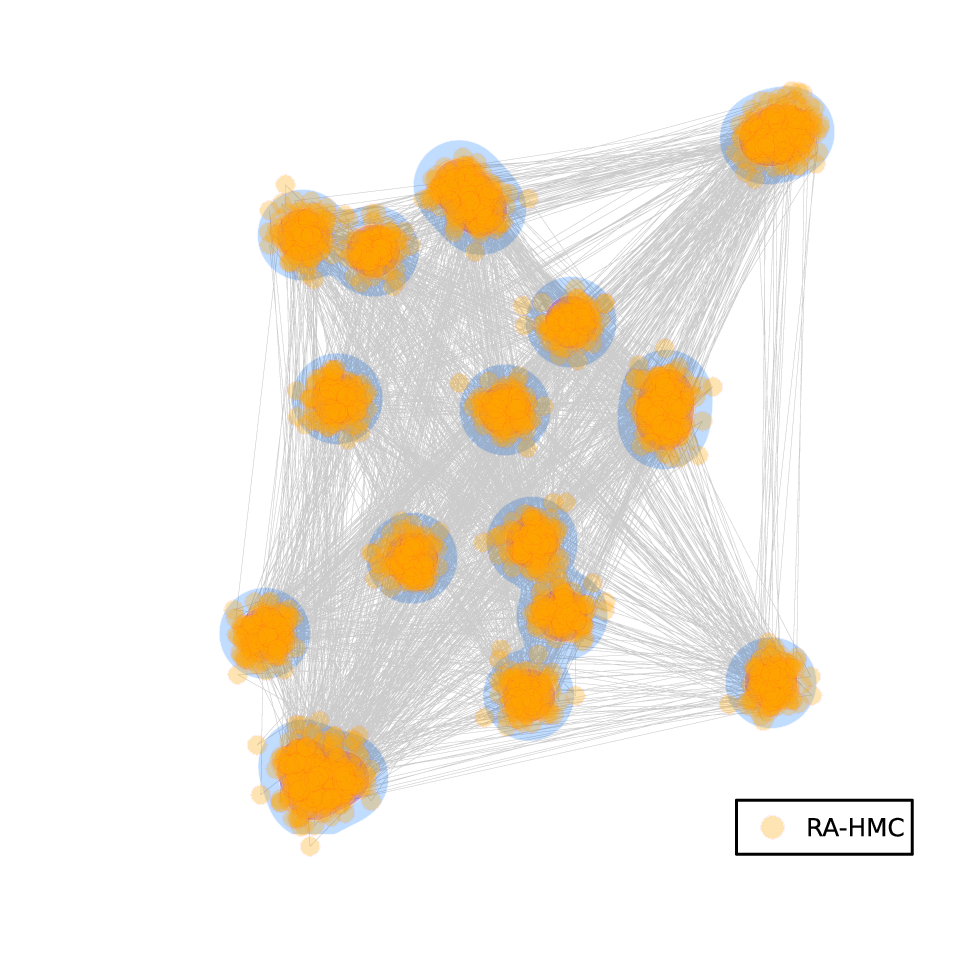
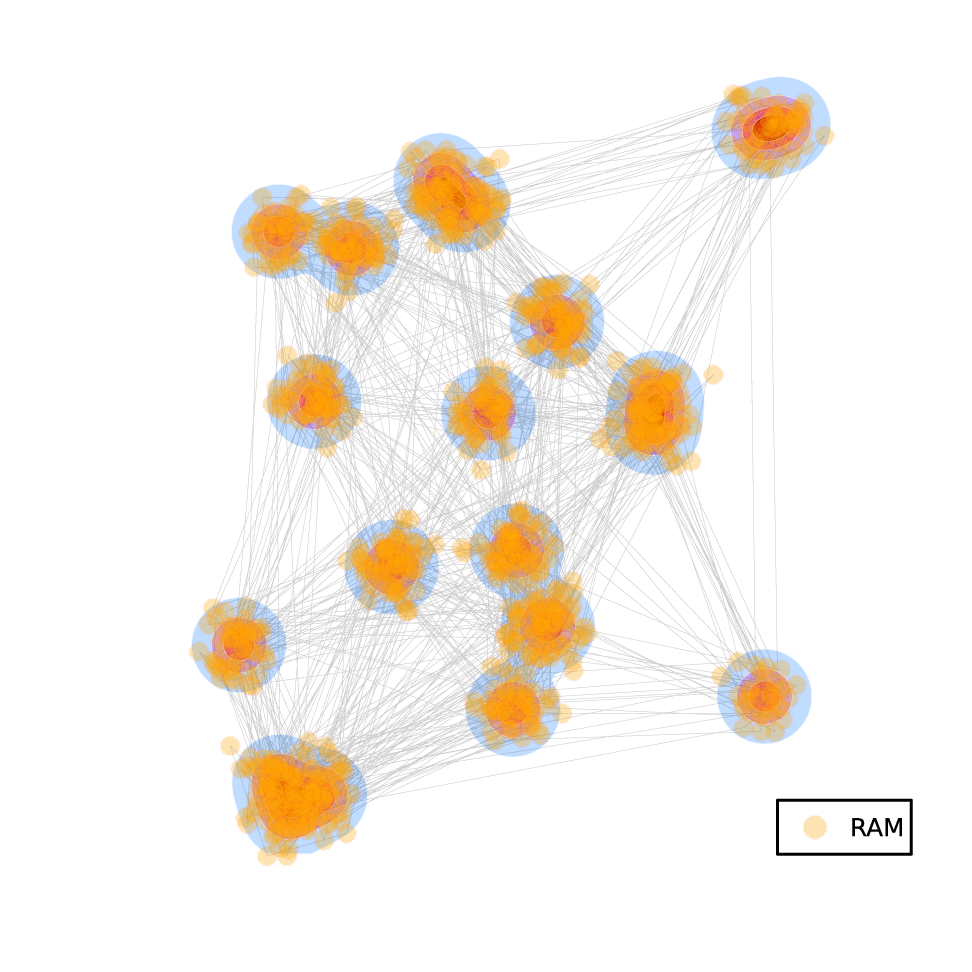
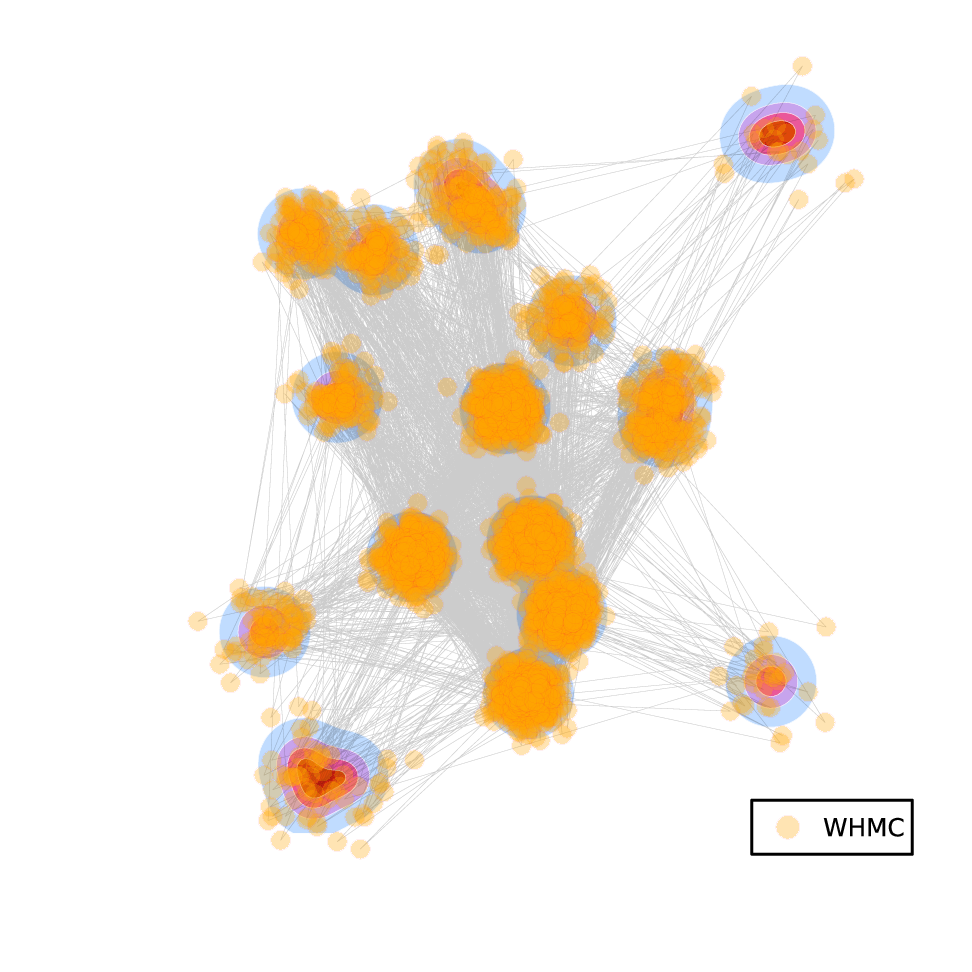
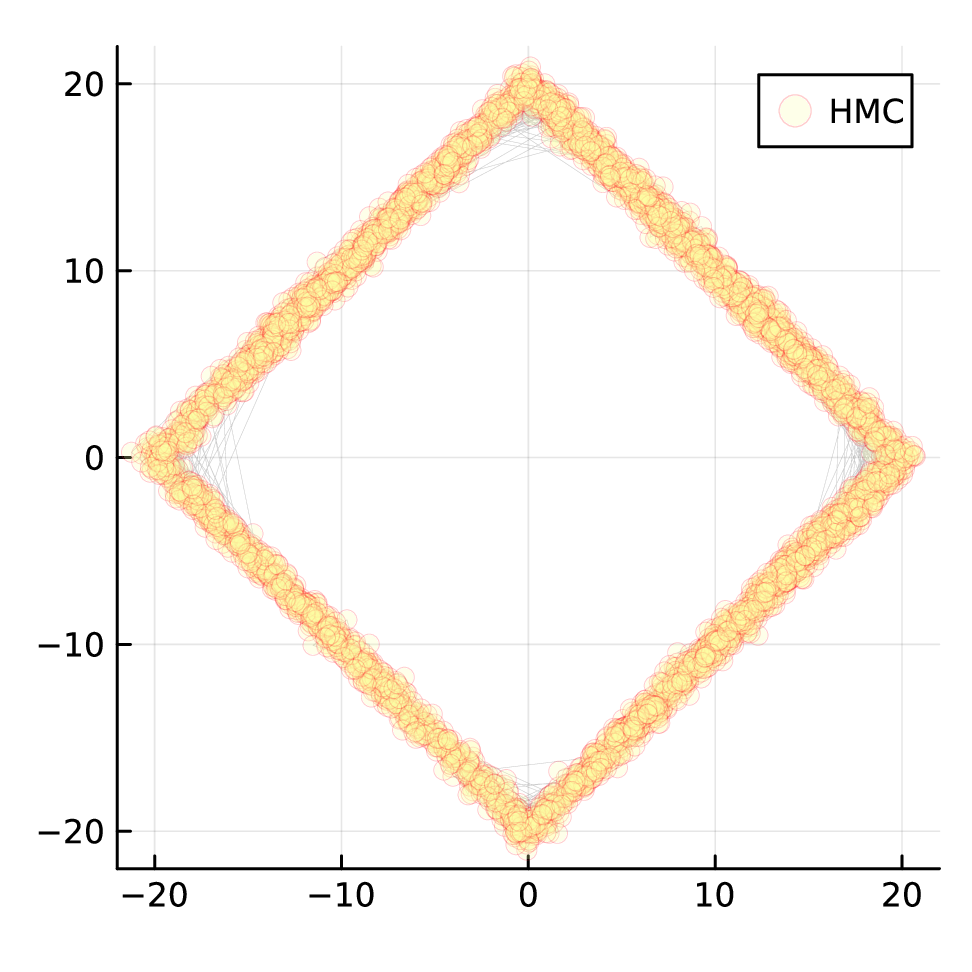
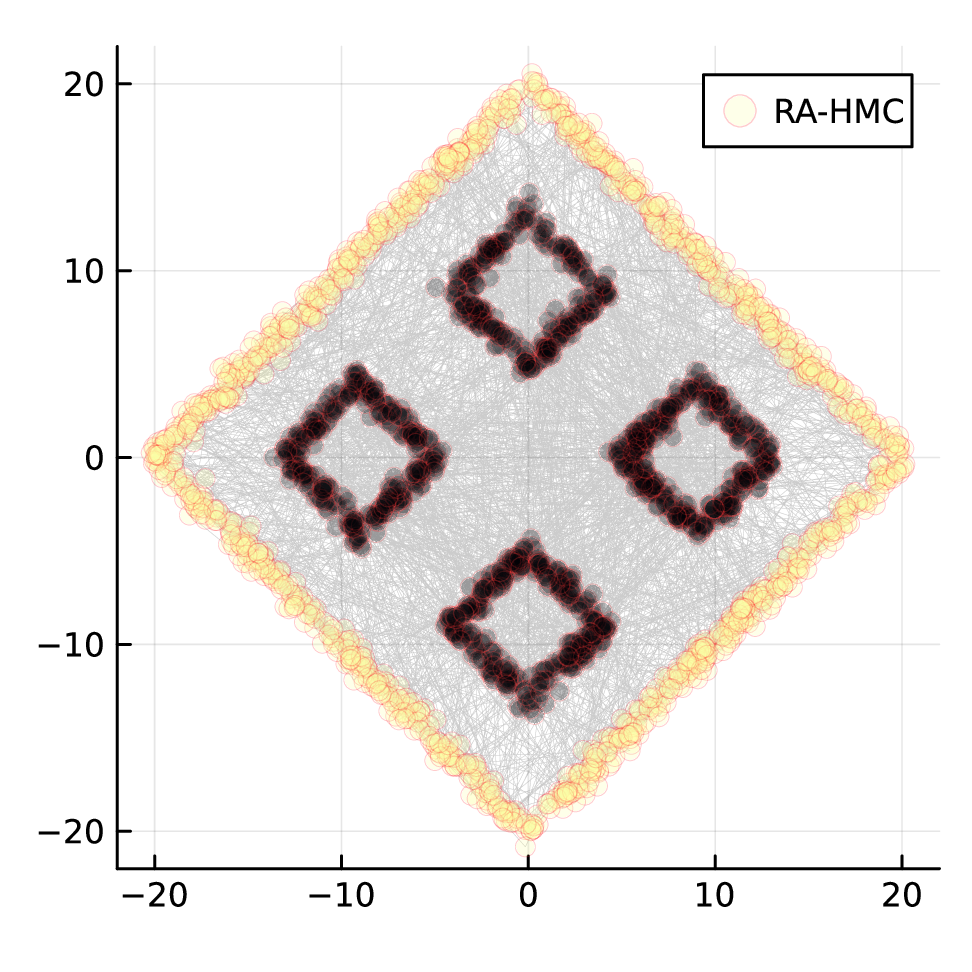
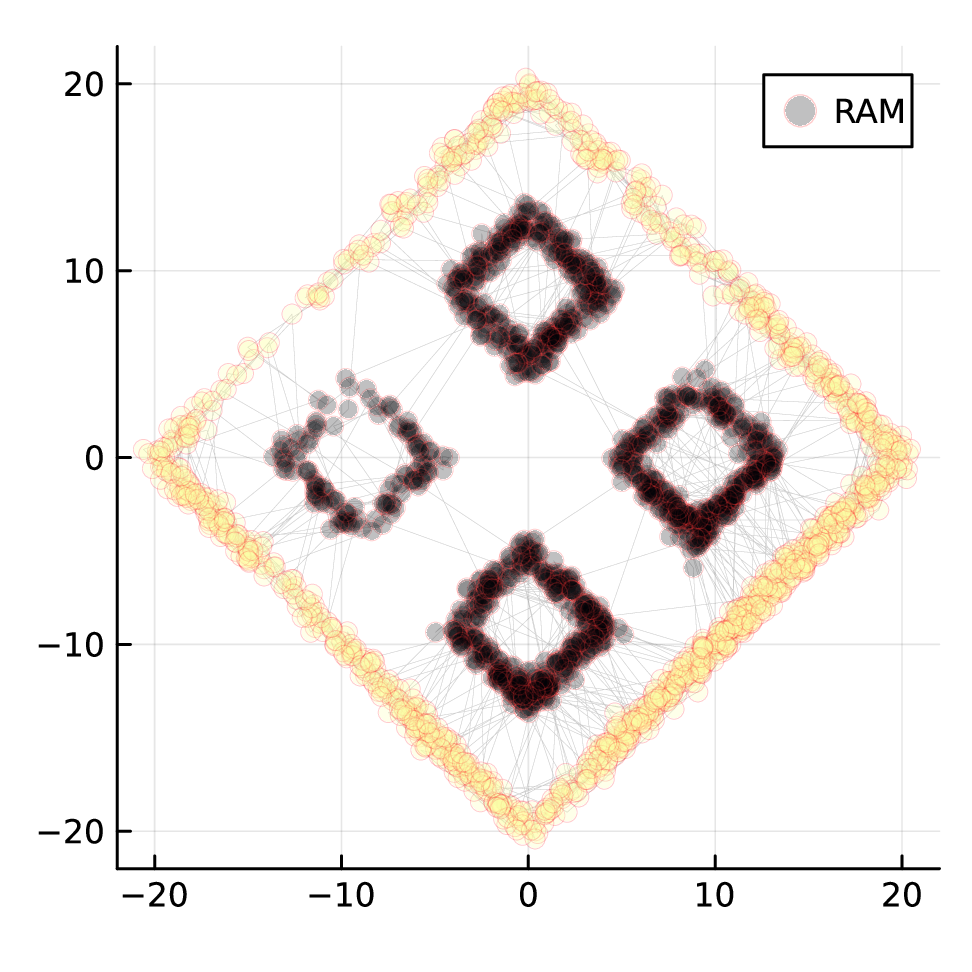
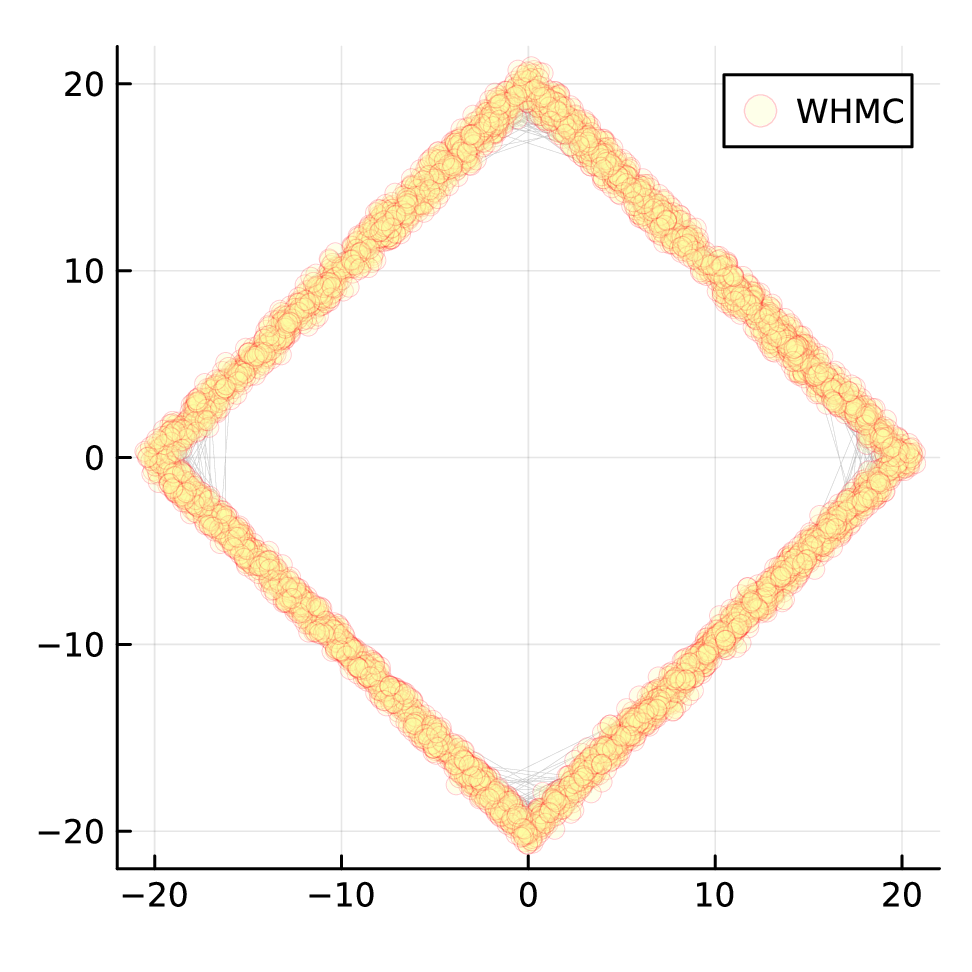
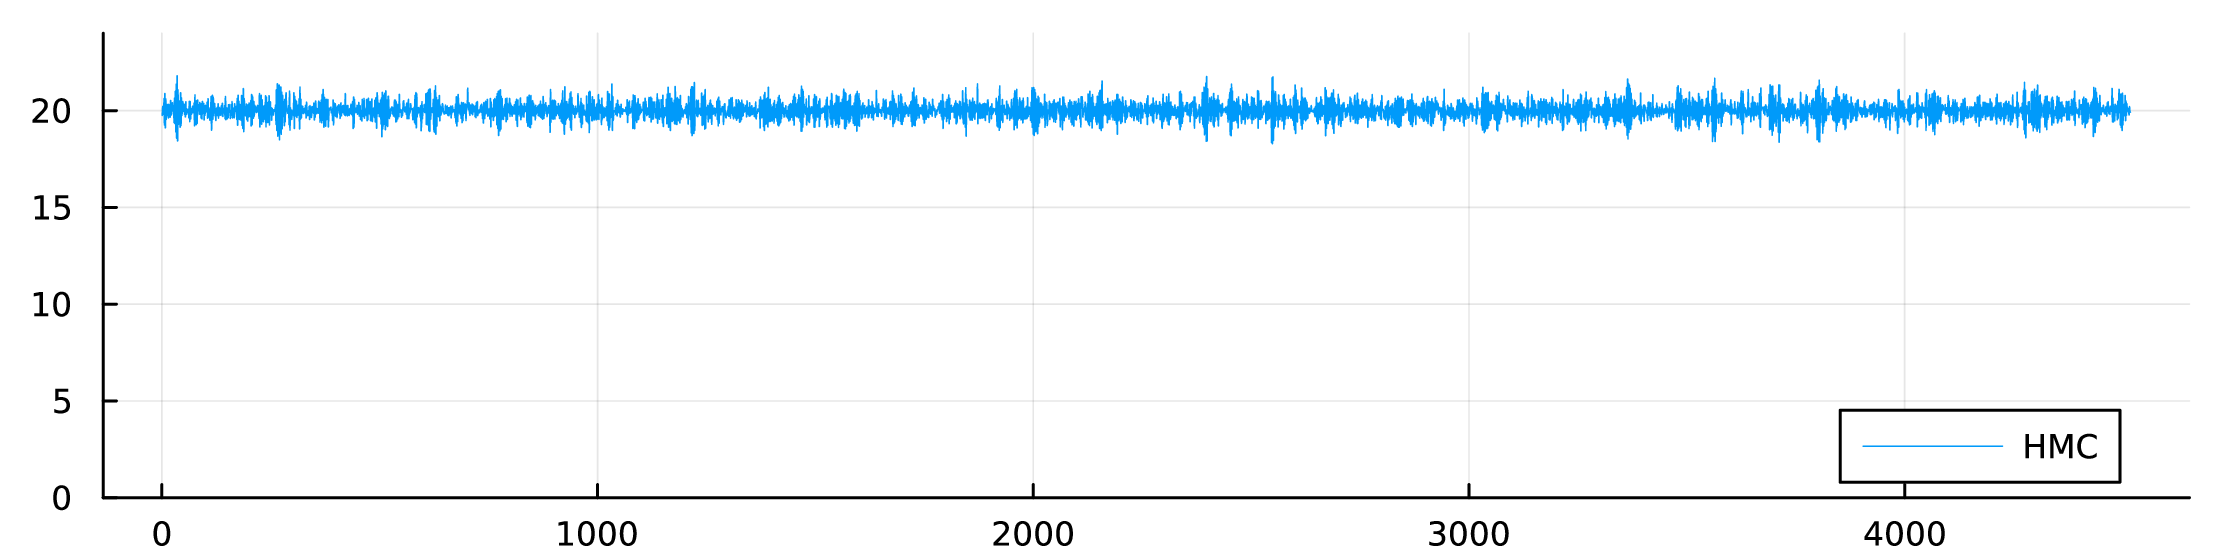
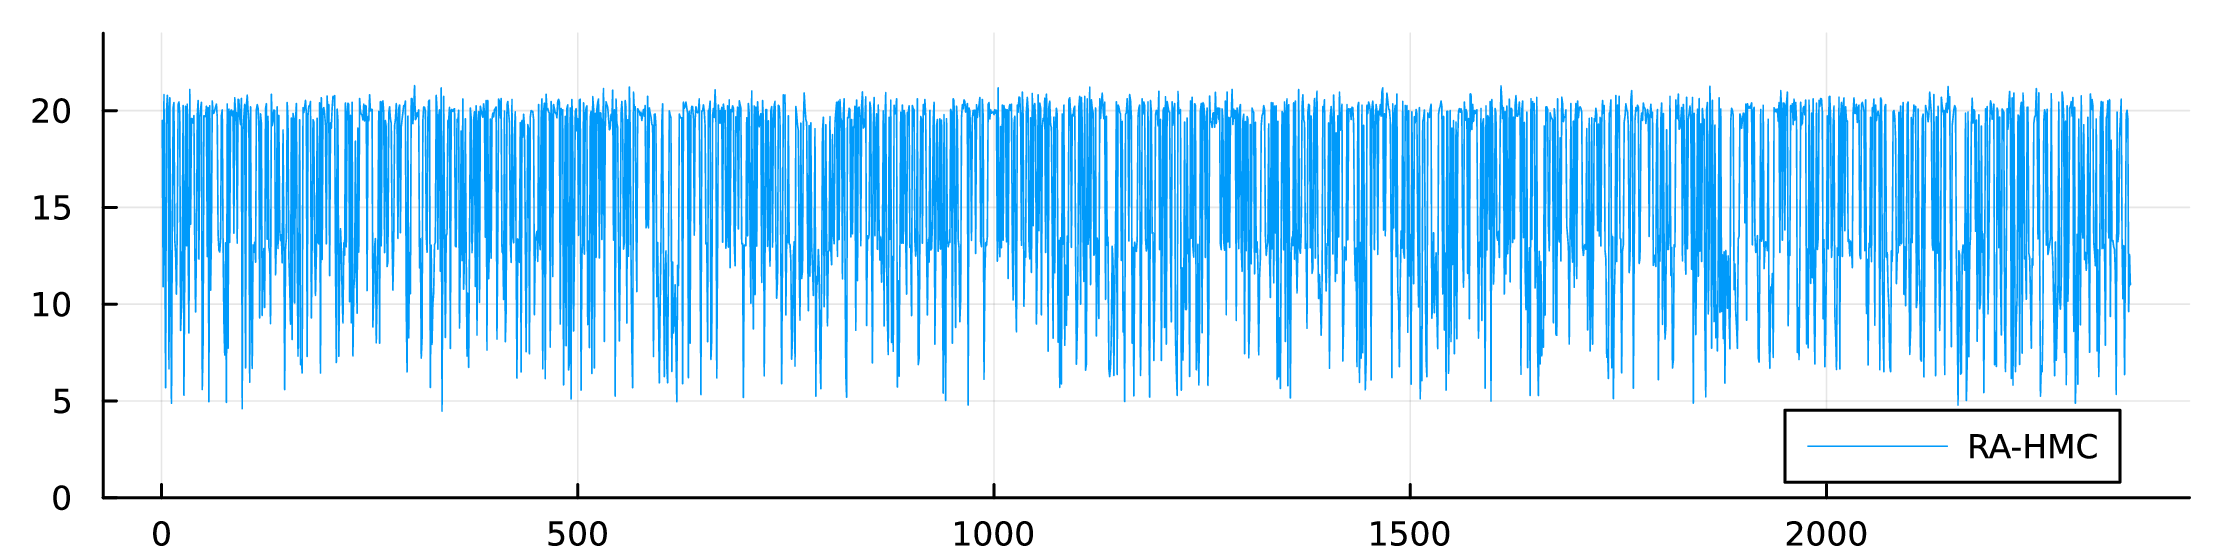
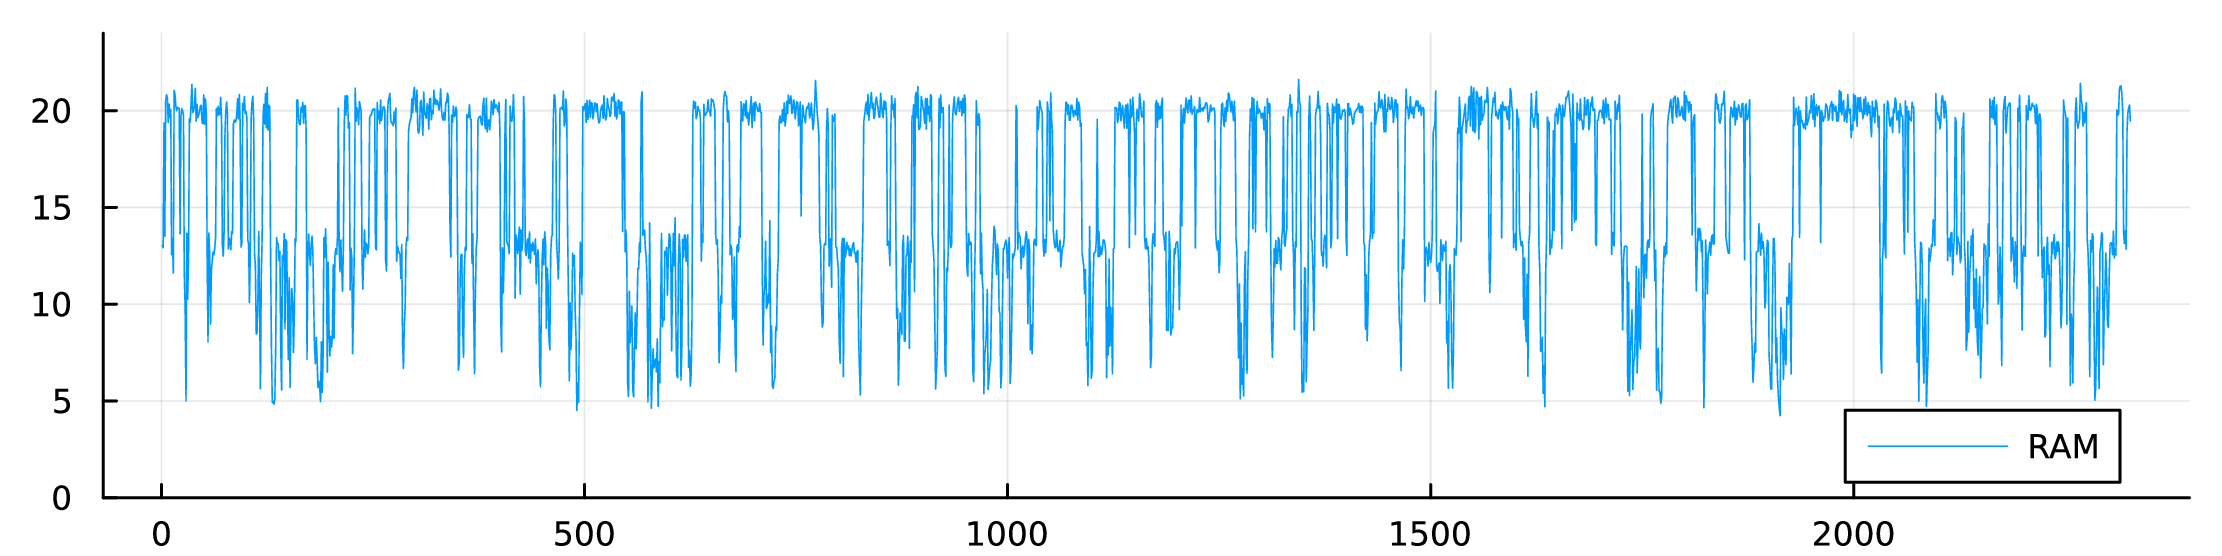
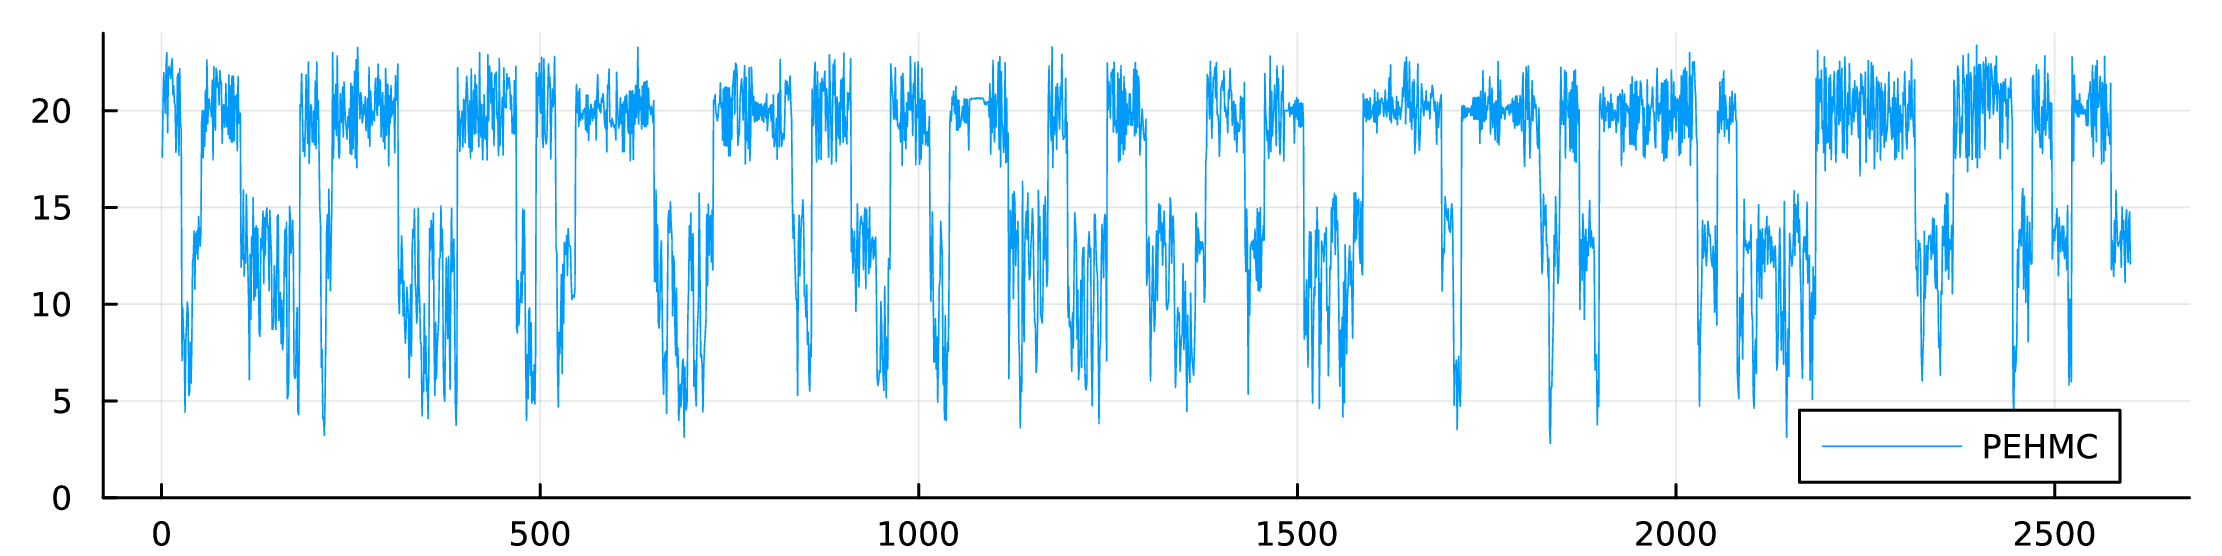
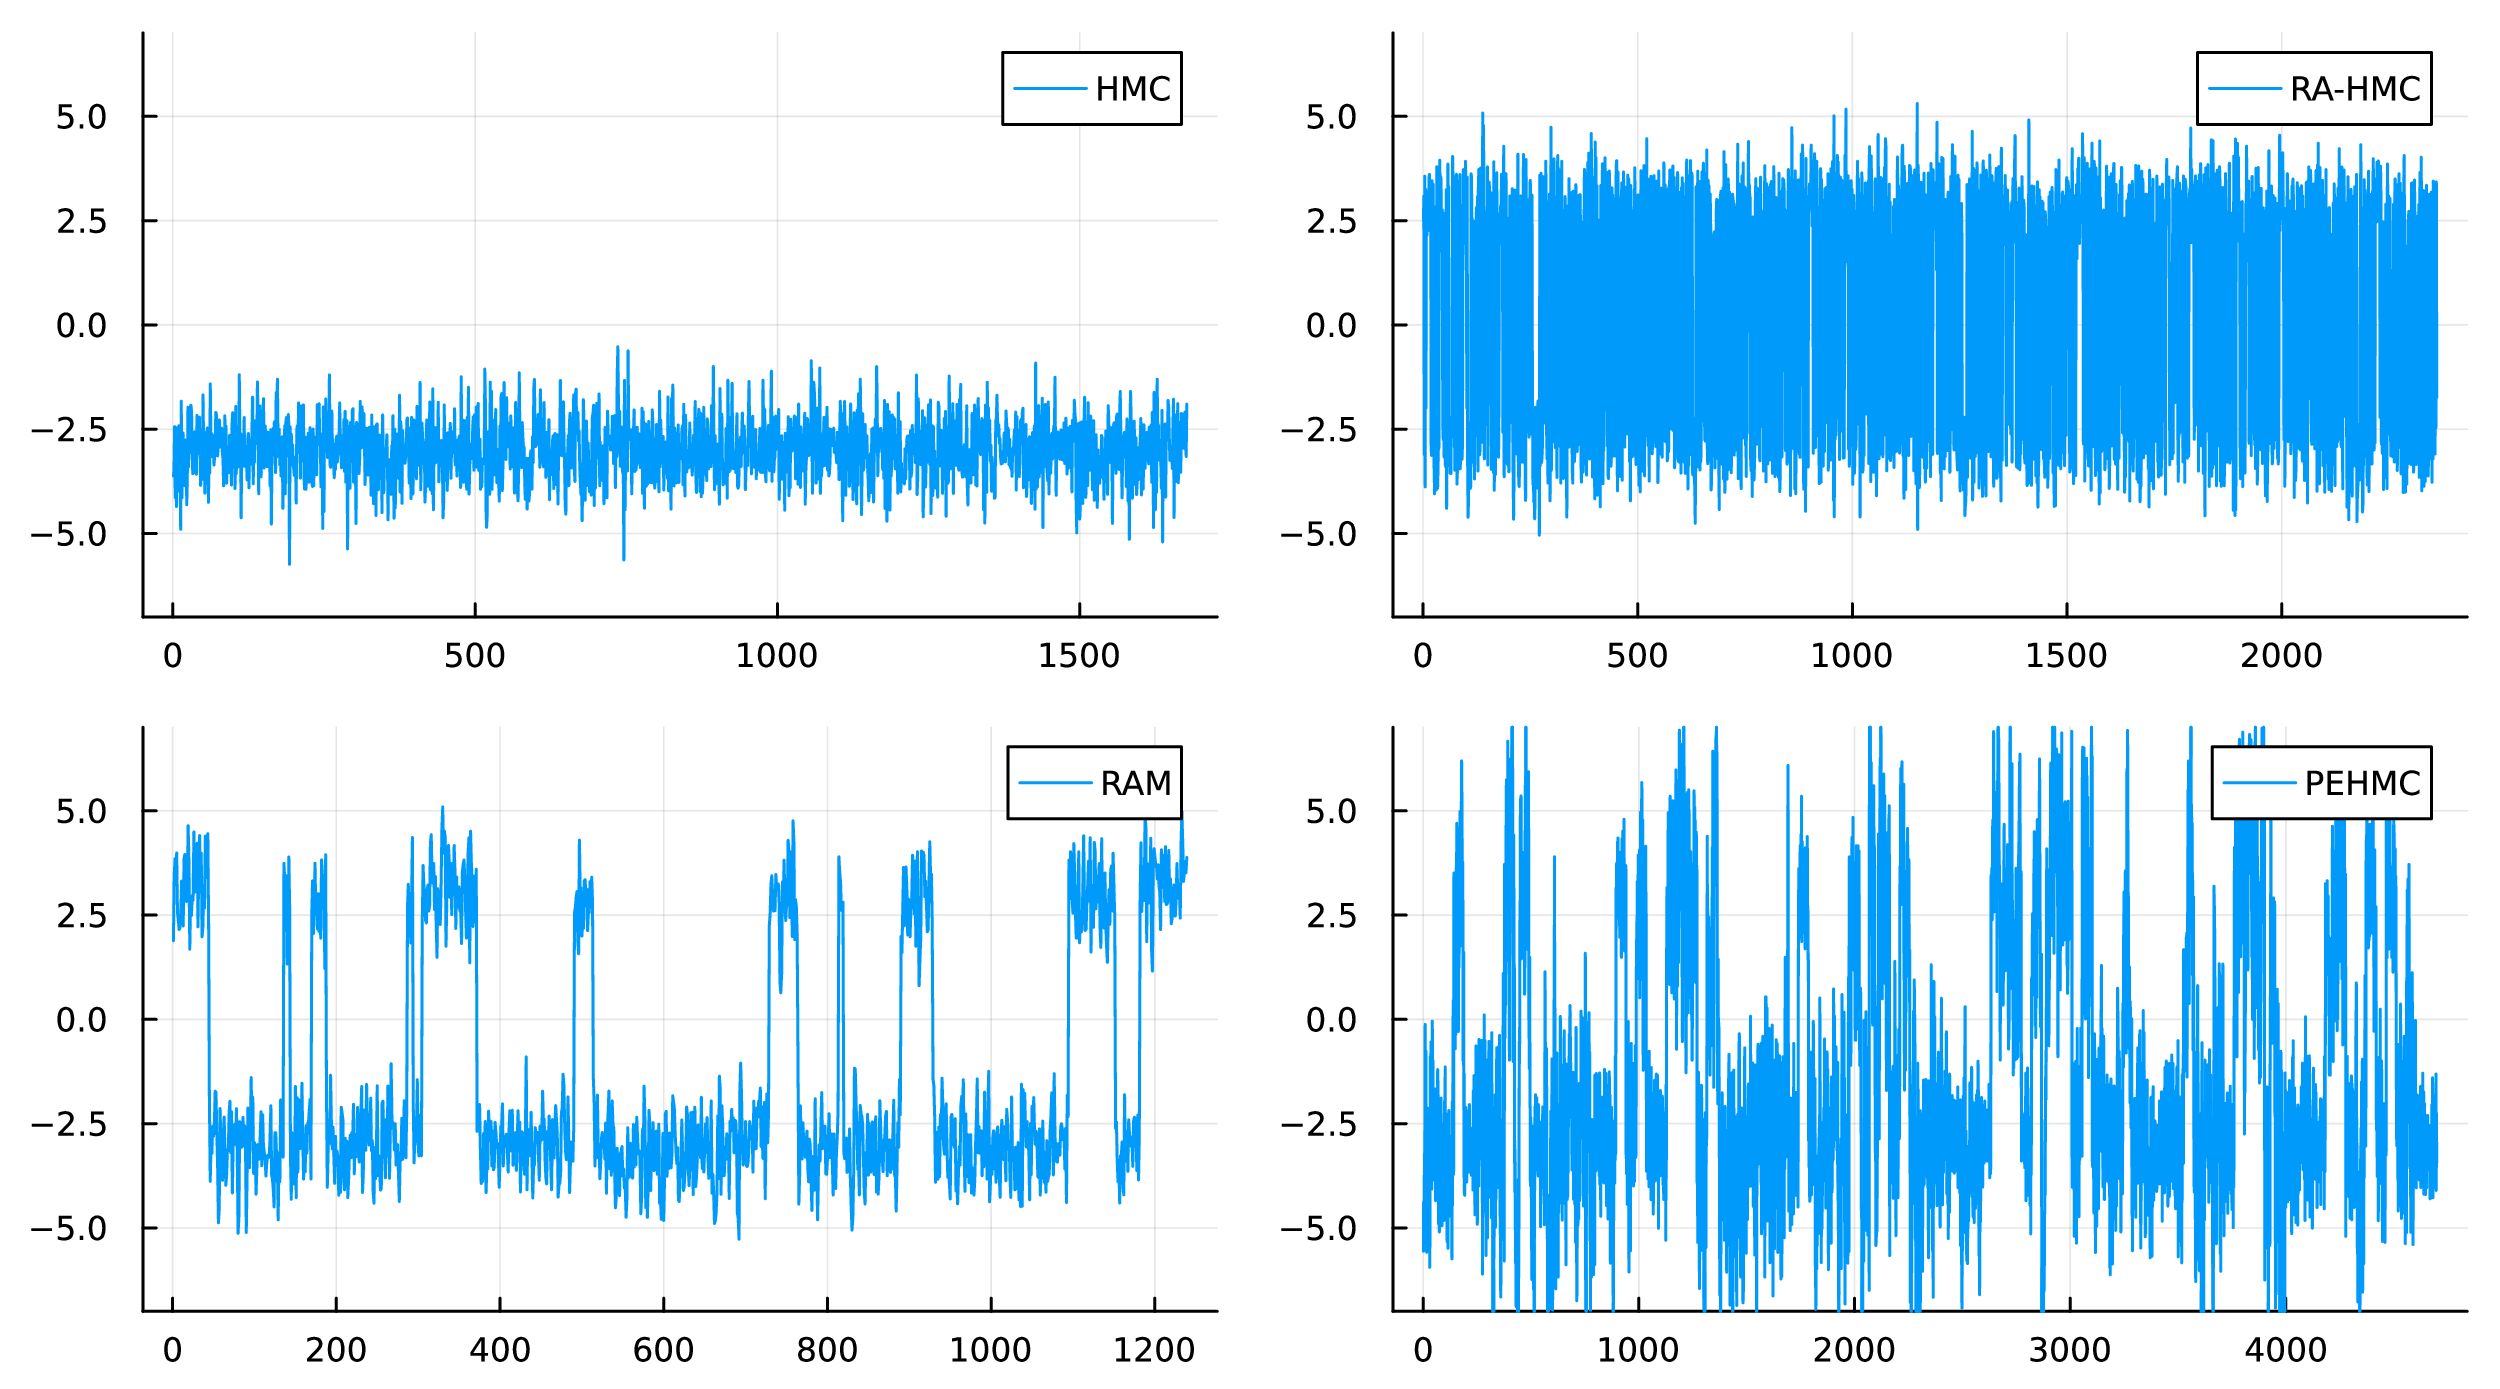
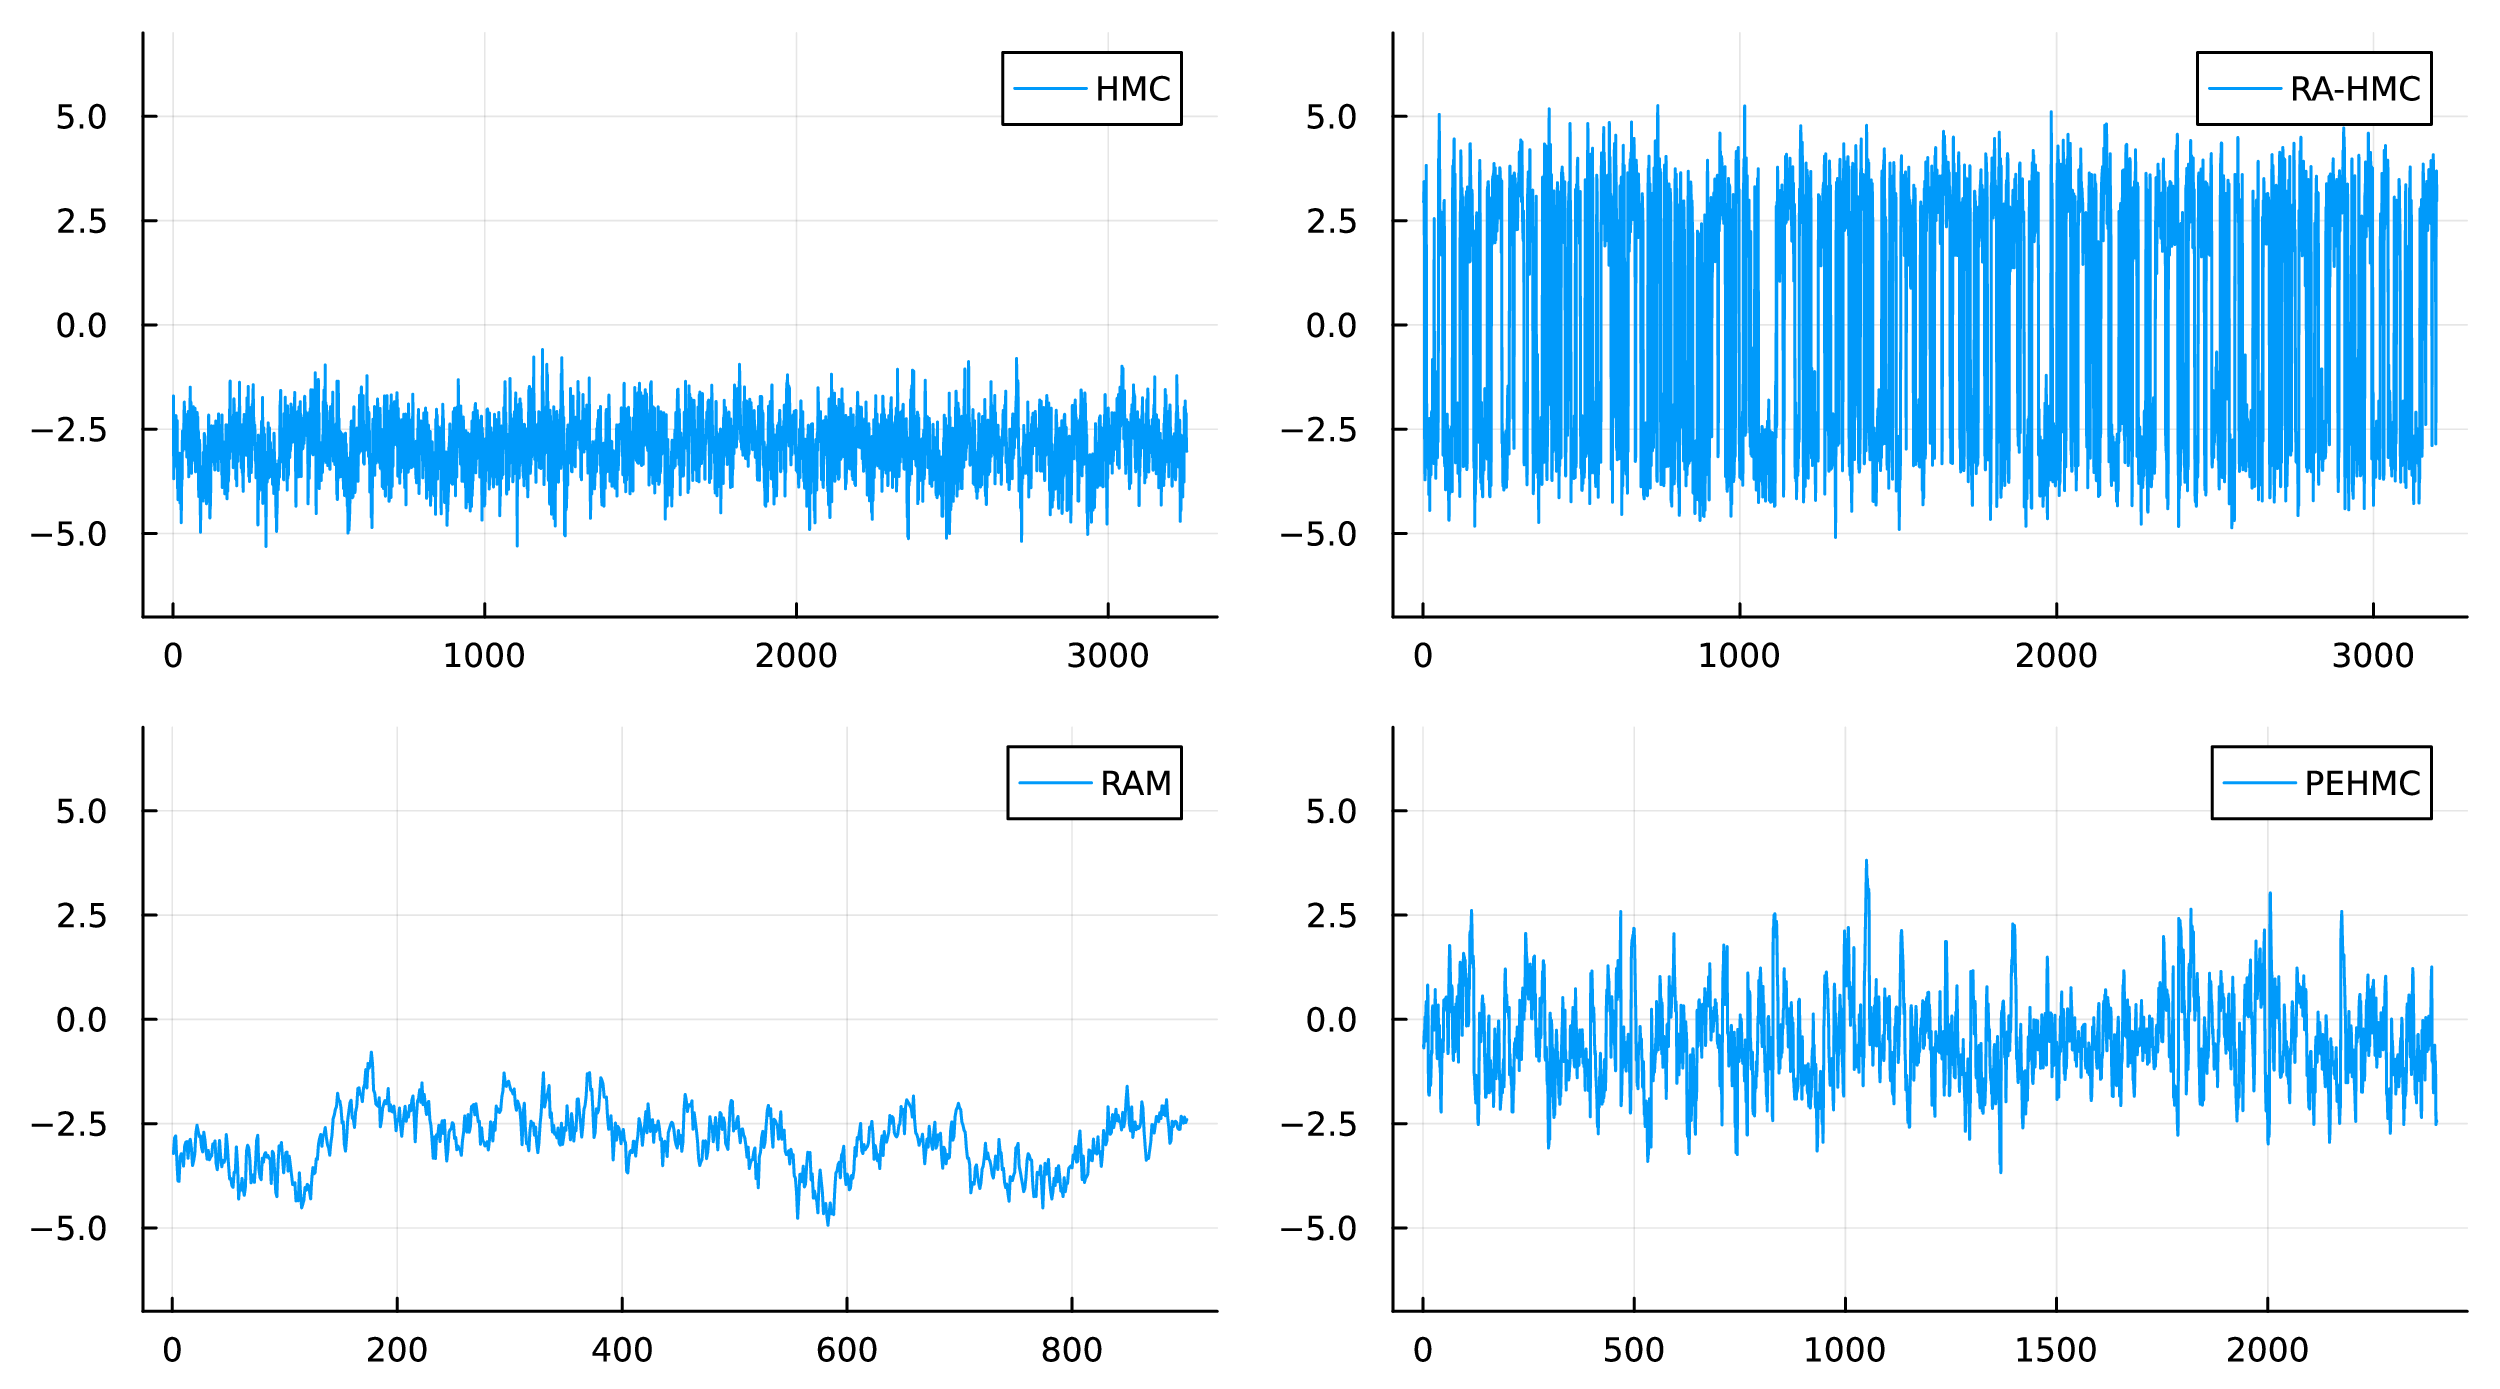
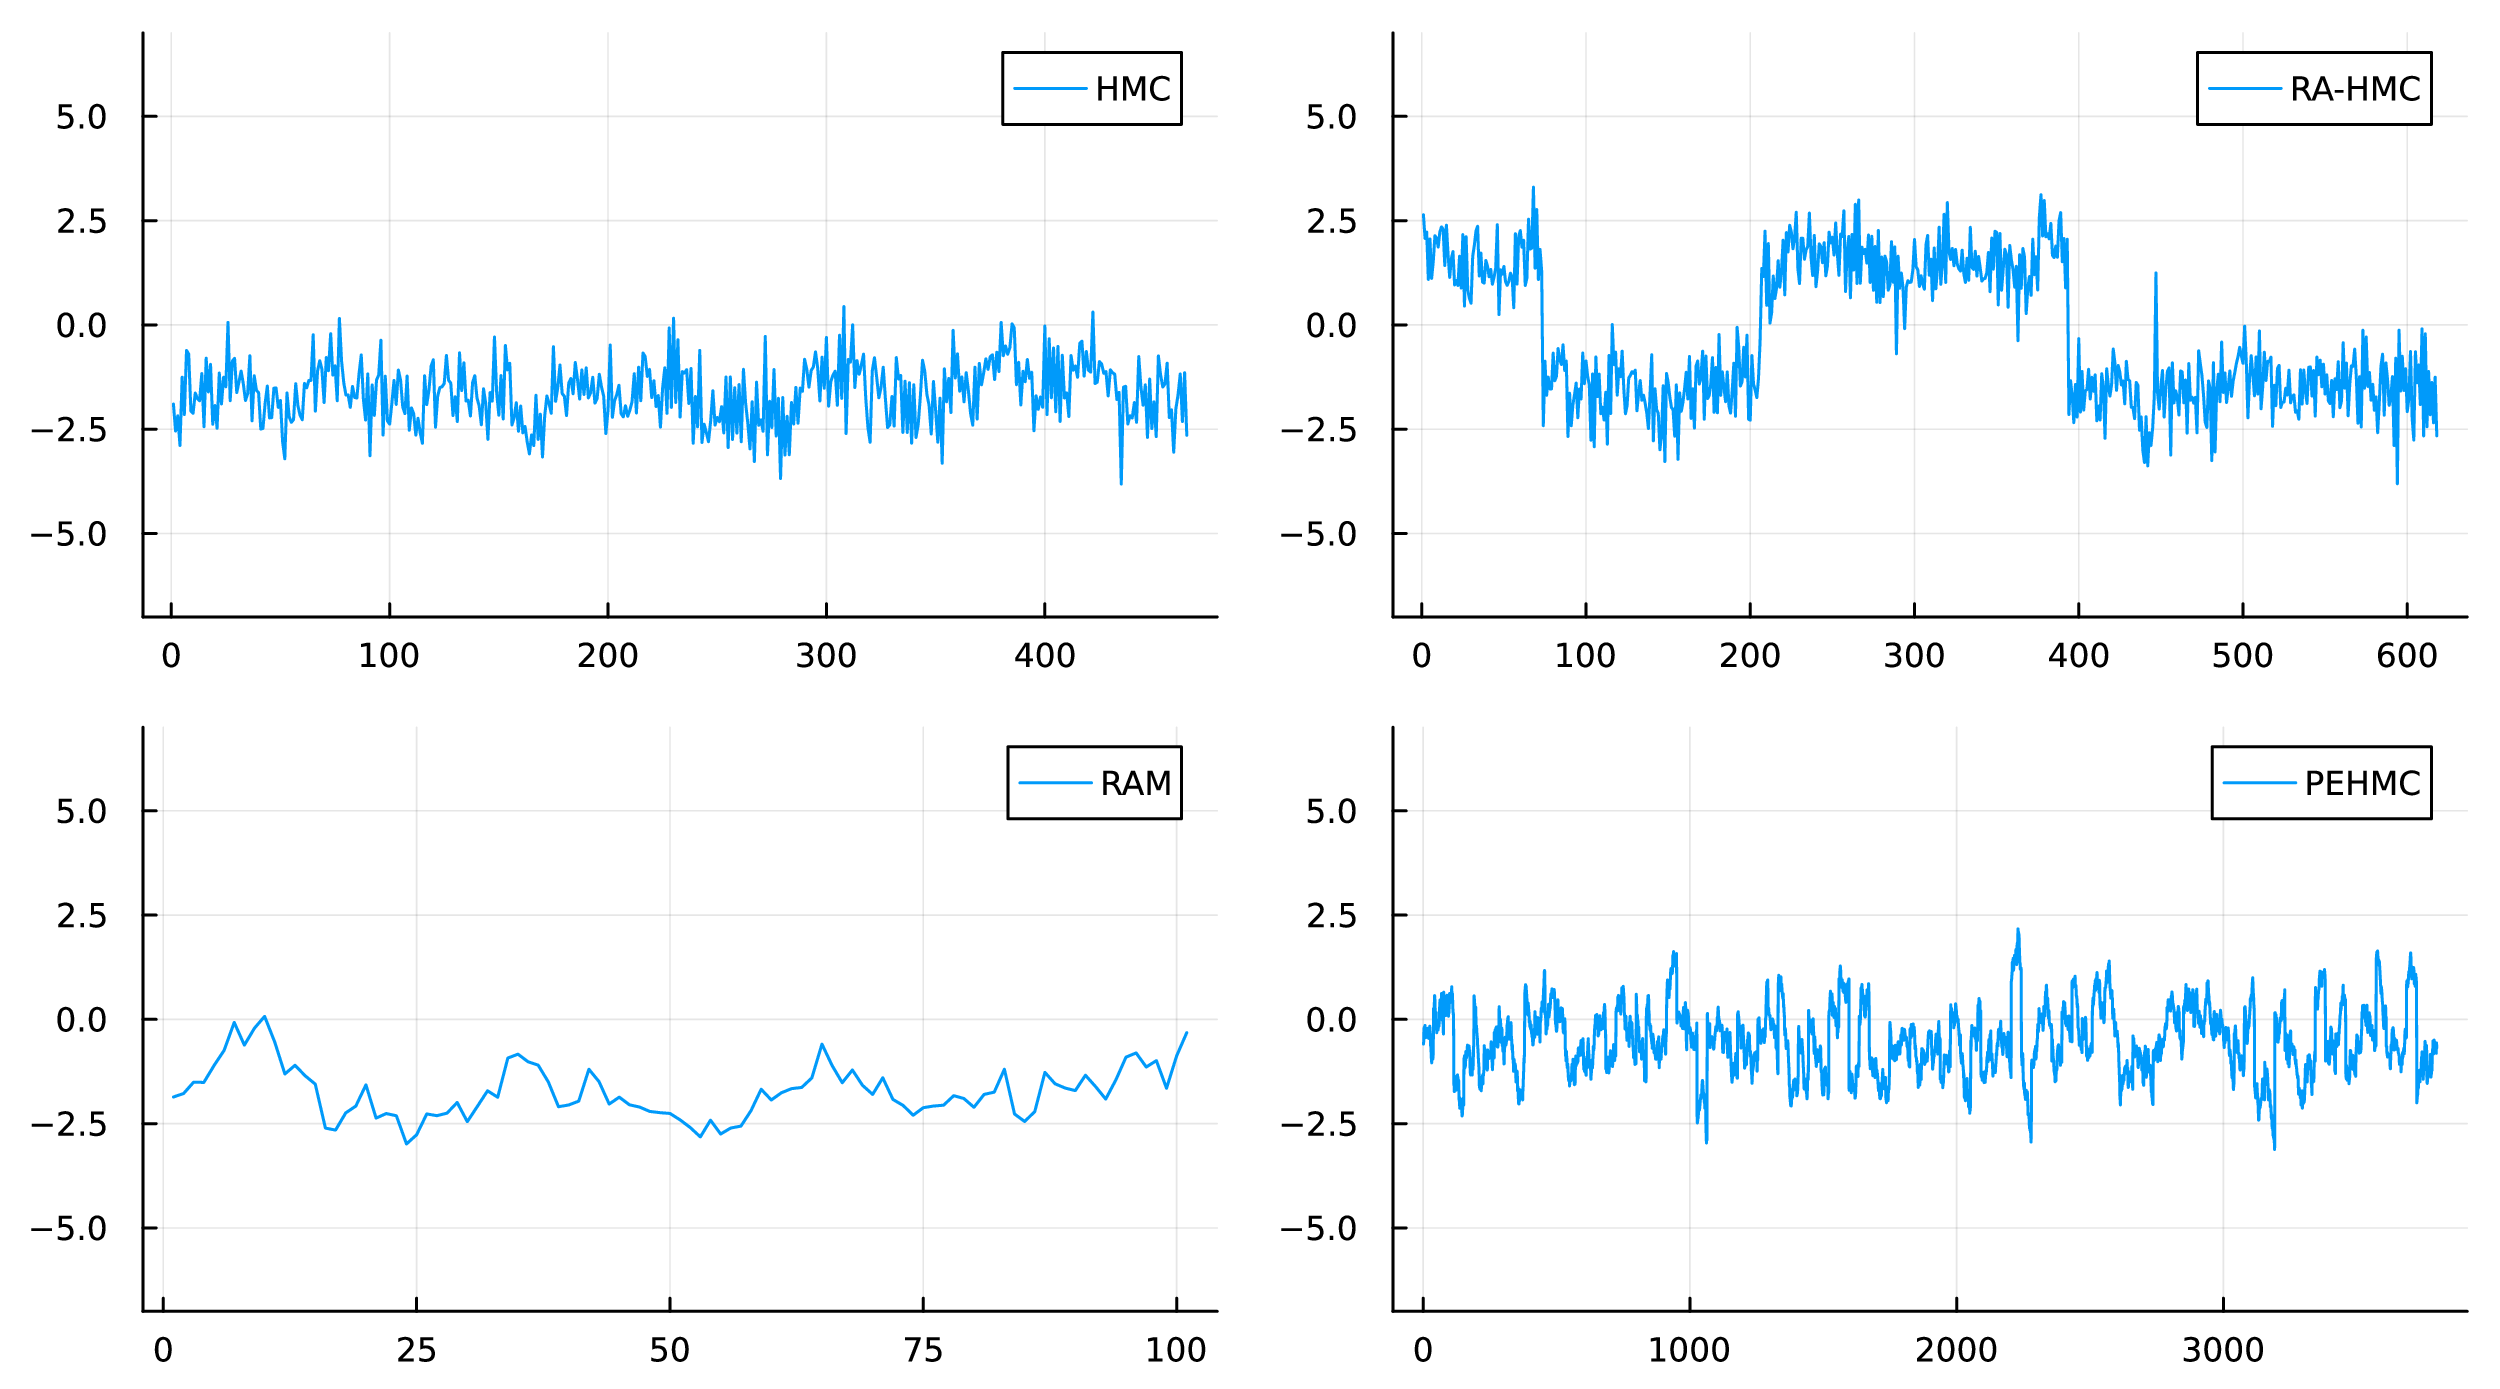
Bimodal Anisotropic Gaussian
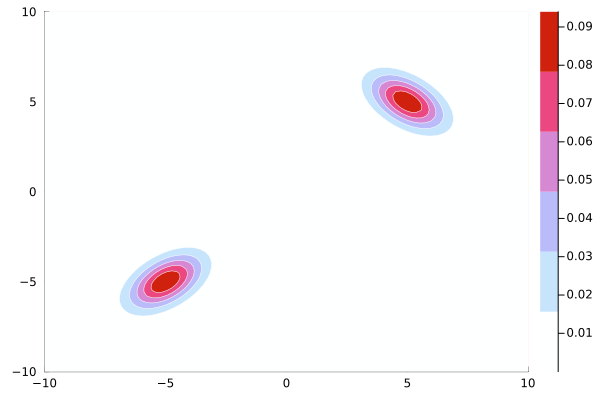
\[ \boxed{\pi \sim \mathcal{N}({\boldsymbol{\mu}}, \Sigma_1) + \mathcal{N}(-{\boldsymbol{\mu}}, \Sigma_2)} \]
where
- \({\boldsymbol{\mu}}= 5 {\mathbf{1}}_d \in {\mathbb R}^d\)
- \(d \in \left\{2, 10, 50\right\}\)
- \(\Sigma_1(i, j) = 0.5^{|i-j|}\)
- \(\Sigma_2 = Q \Sigma_1 Q^\top\) for \(Q \in SO(d)\)
\(W_2\) metric
| Method | d = 2 | d = 10 | d = 20 | d = 50 | d = 100 |
|---|---|---|---|---|---|
| HMC | 3.33 | 5.55 | 8.07 | 13.11 | 19.56 |
| RAHMC | 0.39 | 0.77 | 1.35 | 1.99 | 3.50 |
| RAM | 0.26 | 5.46 | 8.12 | 13.50 | 20.21 |
| PEHMC | 0.71 | 3.79 | 6.64 | 12.41 | 18.83 |
Acceptance Rate
| Method | d = 2 | d = 10 | d = 20 | d = 50 | d = 100 |
|---|---|---|---|---|---|
| HMC | 71.7% | 82.8% | 59.6% | 91.1% | 97.5% |
| RAHMC | 49.2% | 65.7% | 62.6% | 67.2% | 71.4% |
| RAM | 31.9% | 11.8% | 43.7% | 29.1% | 50.1% |
| PEHMC | 92.0% | 63.6% | 63.5% | 88.5% | 69.2% |
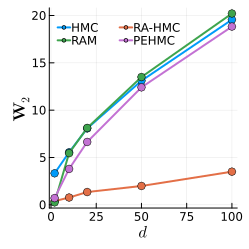
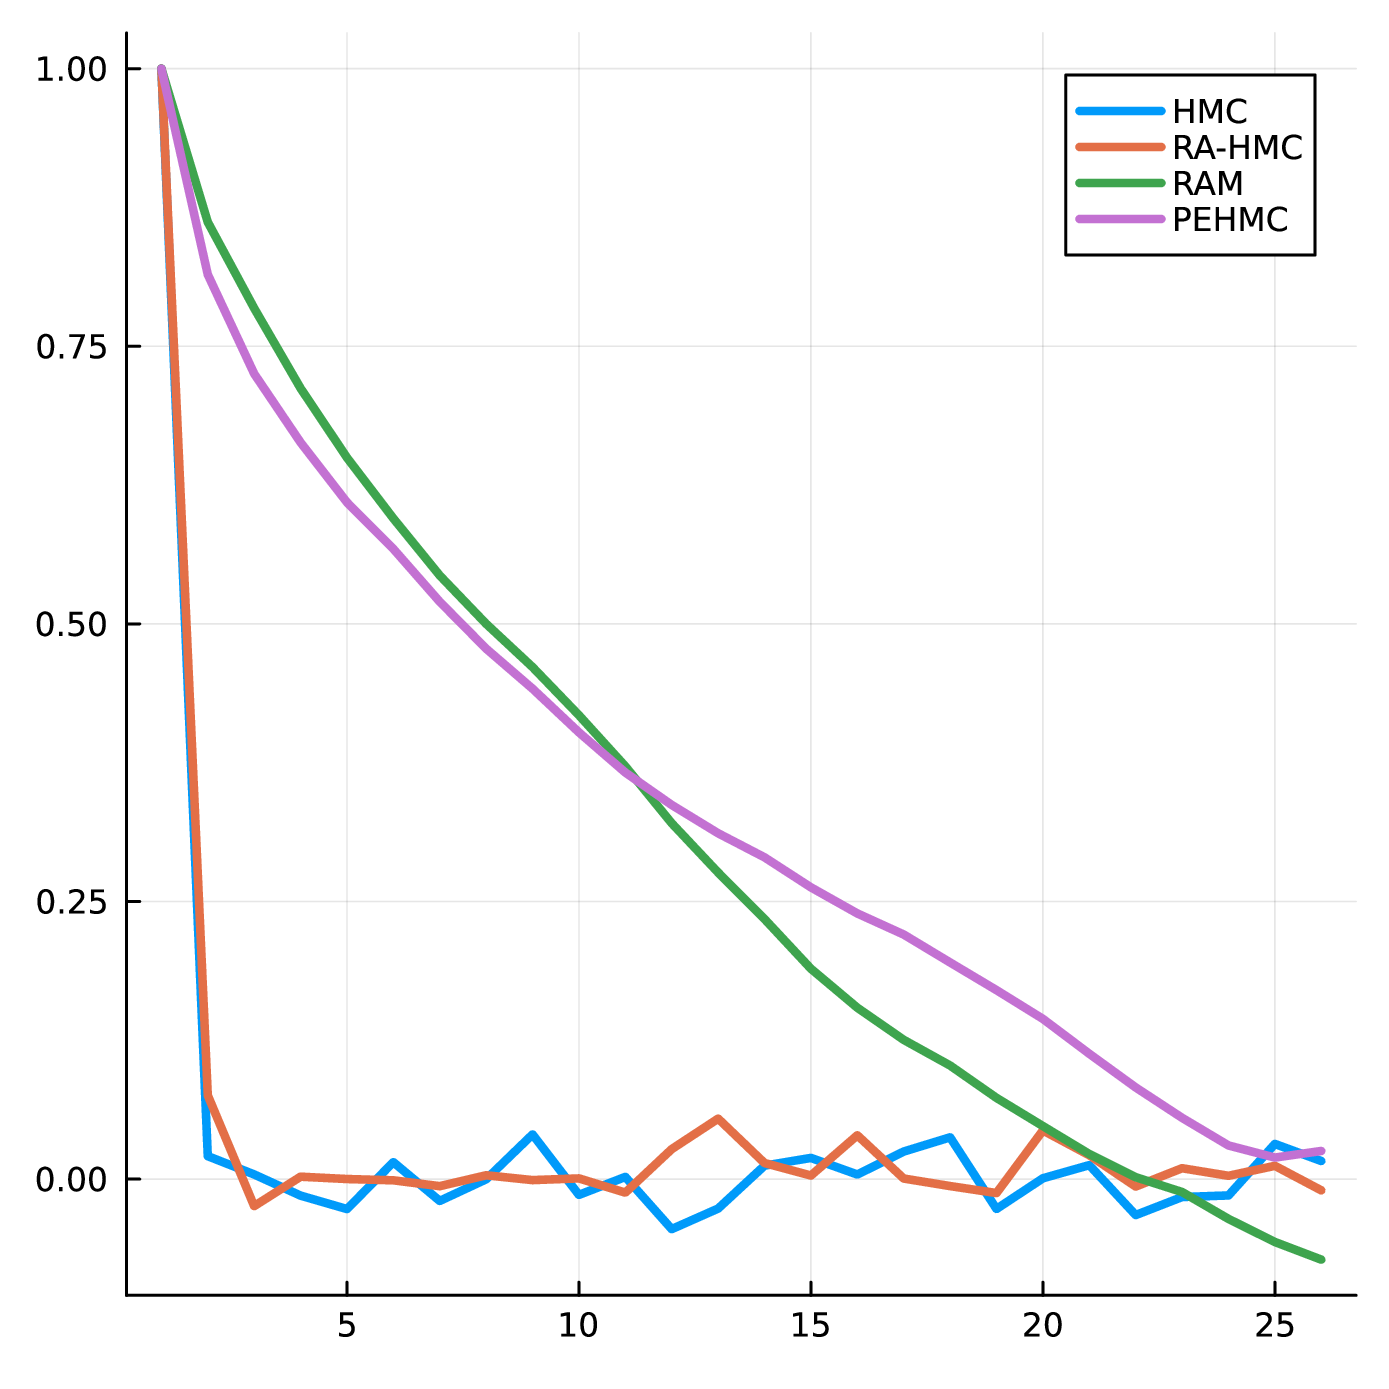
\(d=2\)
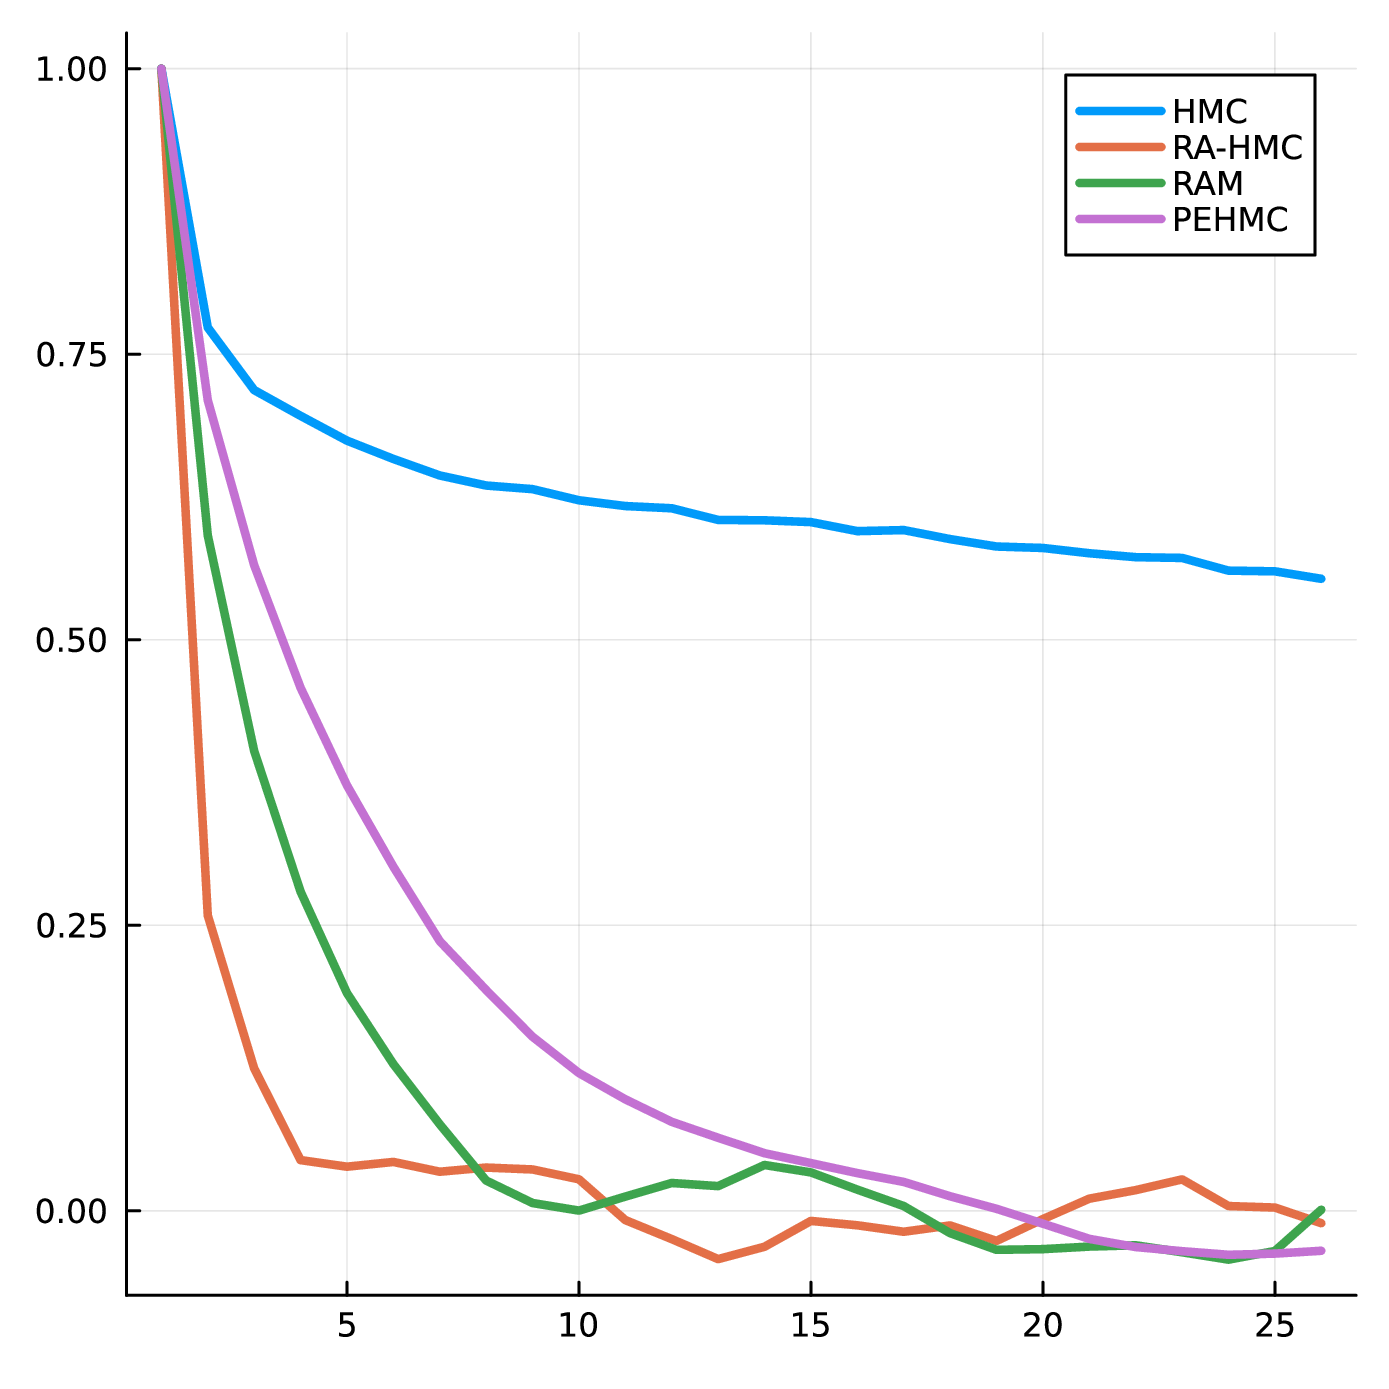
\(d=20\)
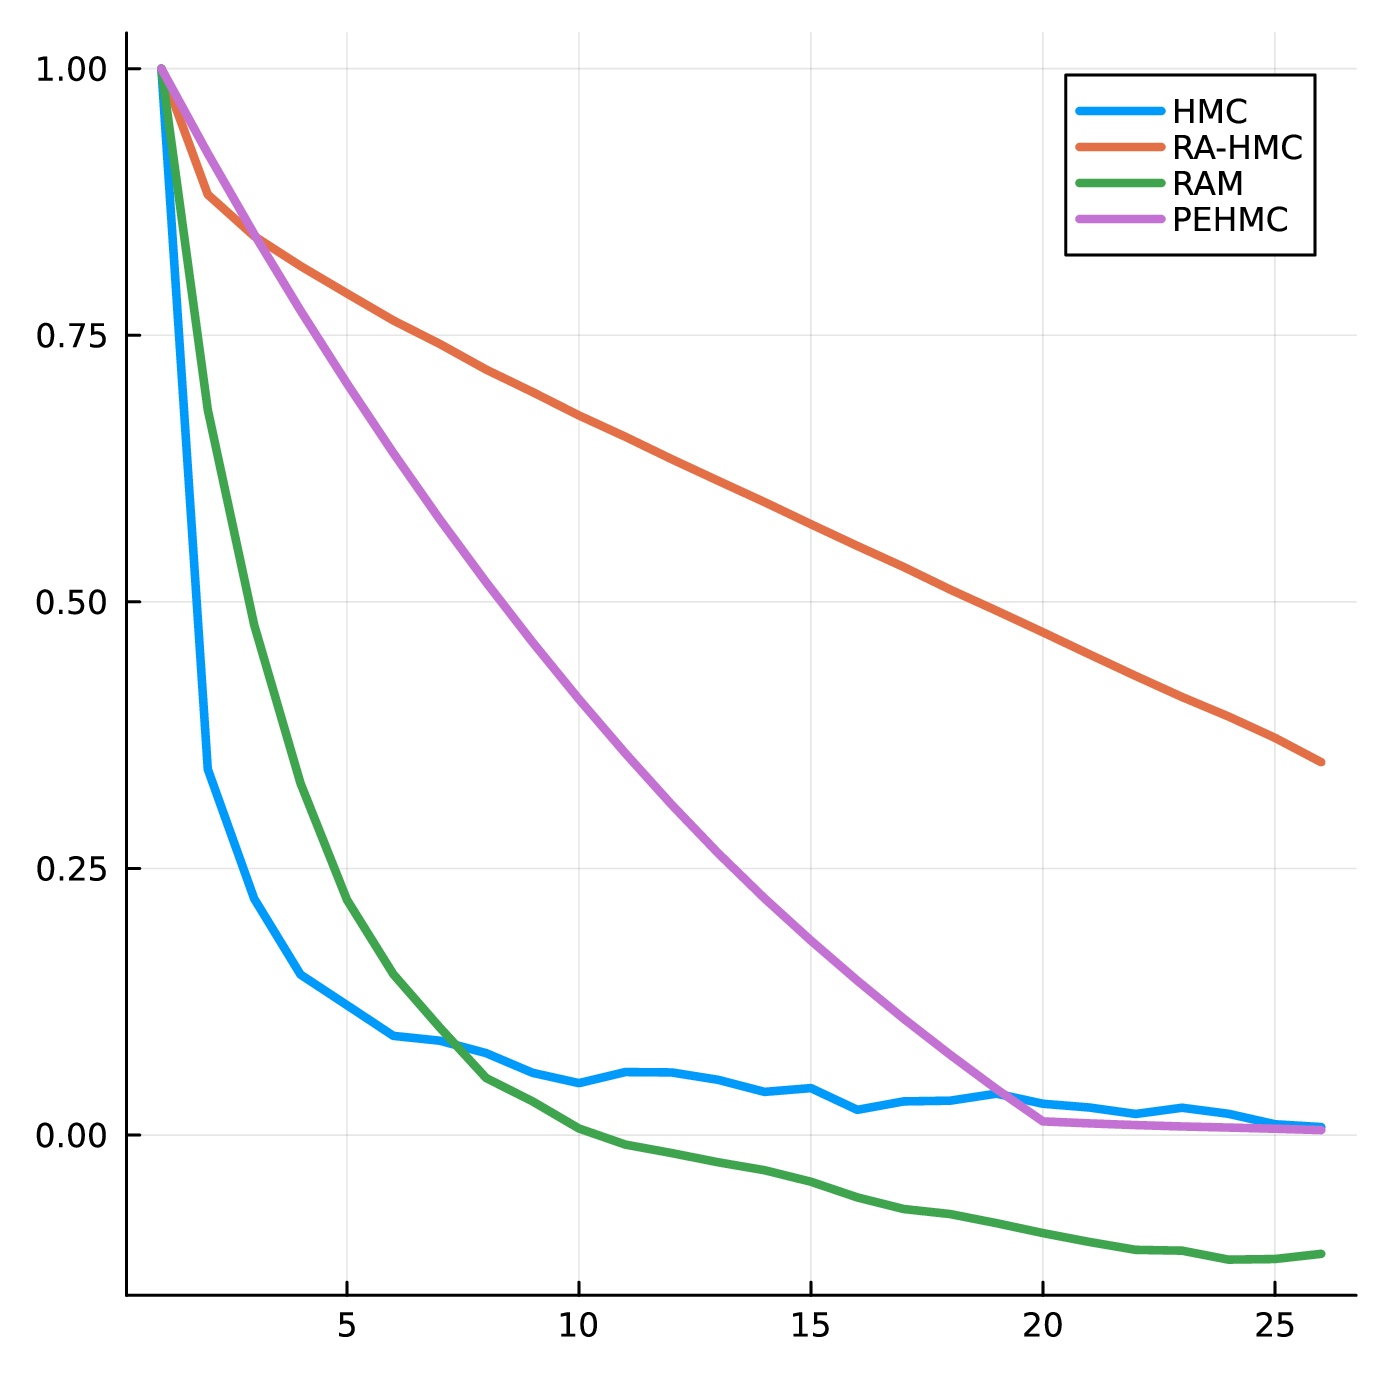
\(d=100\)
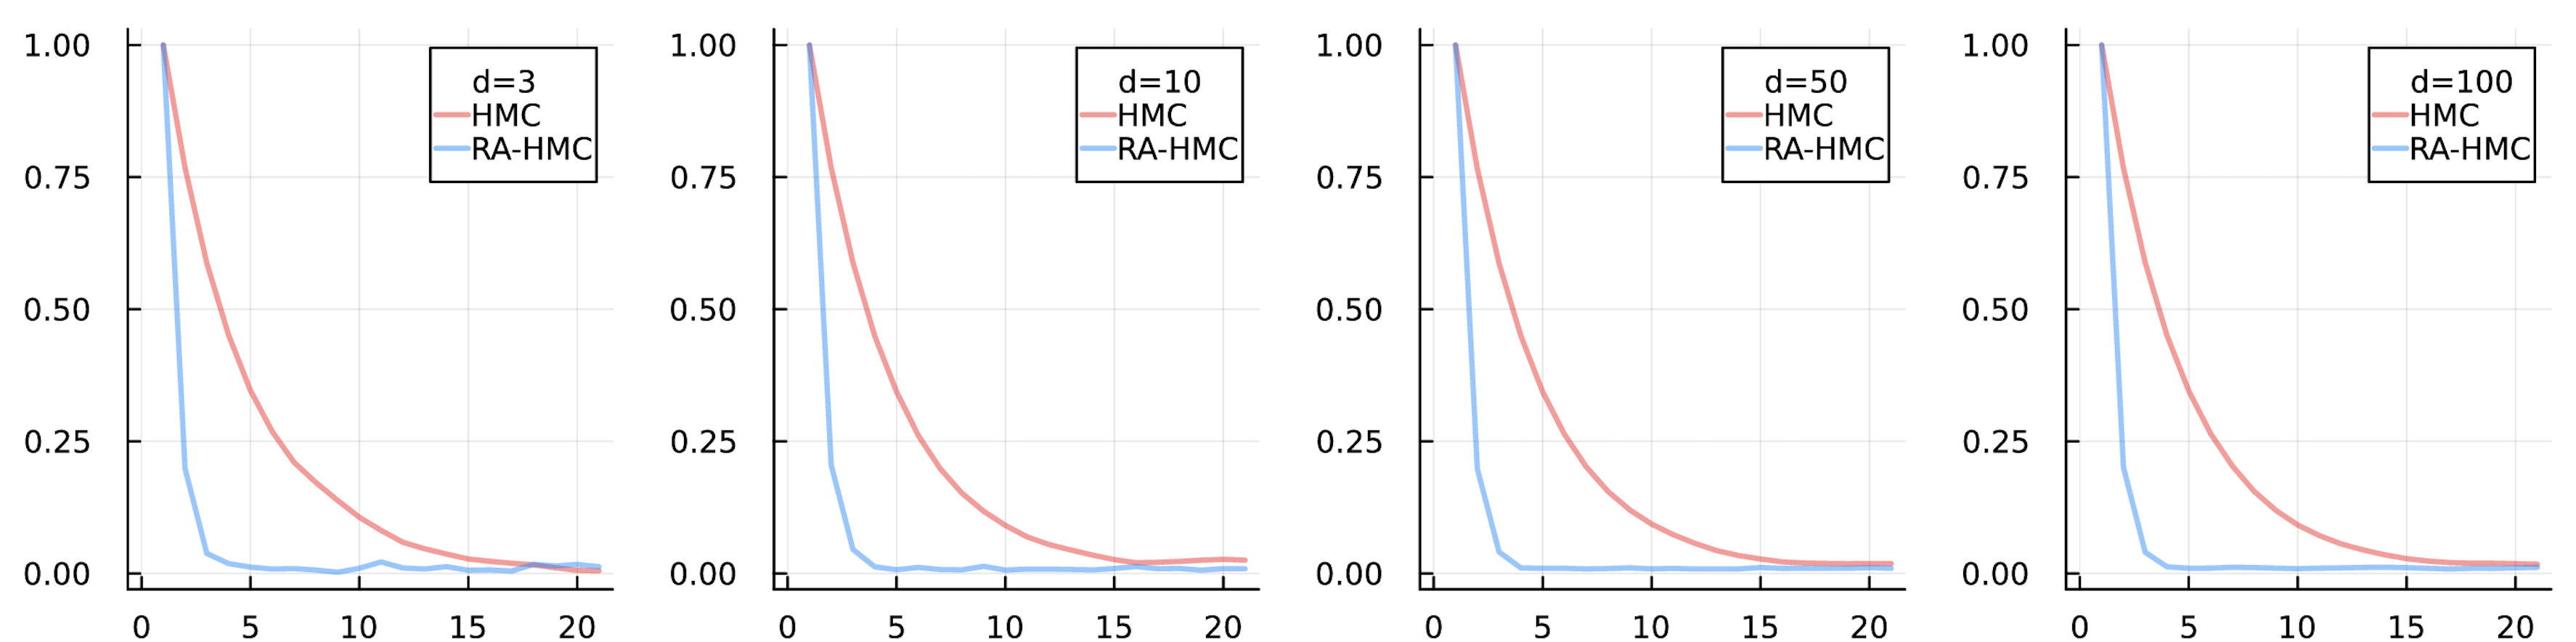
Enhanced Mixing Unimodal Gaussian
\[ \boxed{\pi \propto \mathsf{N}(0_d, {\mathbb I}_{d})} \]
With:
- \(d \in \{3, 10, 50, 100\}\)
- \(n=5,000\) with \(n_{\text{warm-up}}=5,000\)
Methods:
- HMC with \(\epsilon=0.5\) and \(L=20\)
- RAHMC with same \(\epsilon, L\) and \(\gamma=0.05\)
| Method | d = 3 | d = 10 | d = 50 | d = 100 |
|---|---|---|---|---|
| HMC | 0.17 | 3.10 | 53.41 | 133.09 |
| RAHMC | 0.19 | 3.23 | 54.72 | 136.05 |
| Margin of error \(\asymp n^{-1/d}\) | 0.06 | 0.43 | 0.84 | 0.92 |
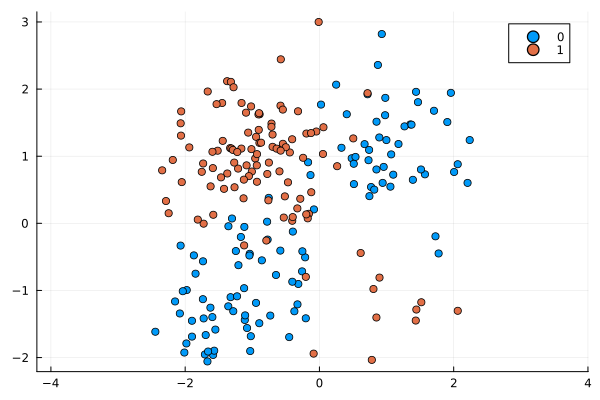
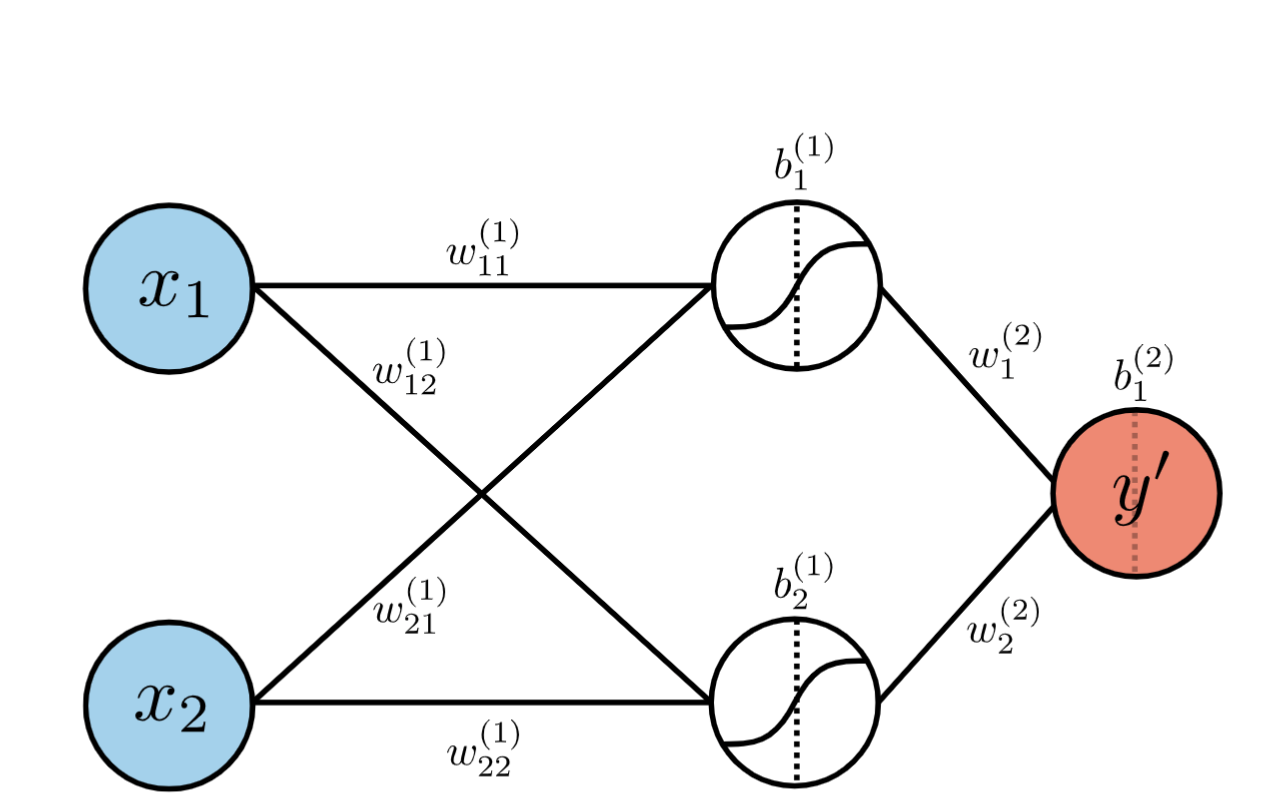
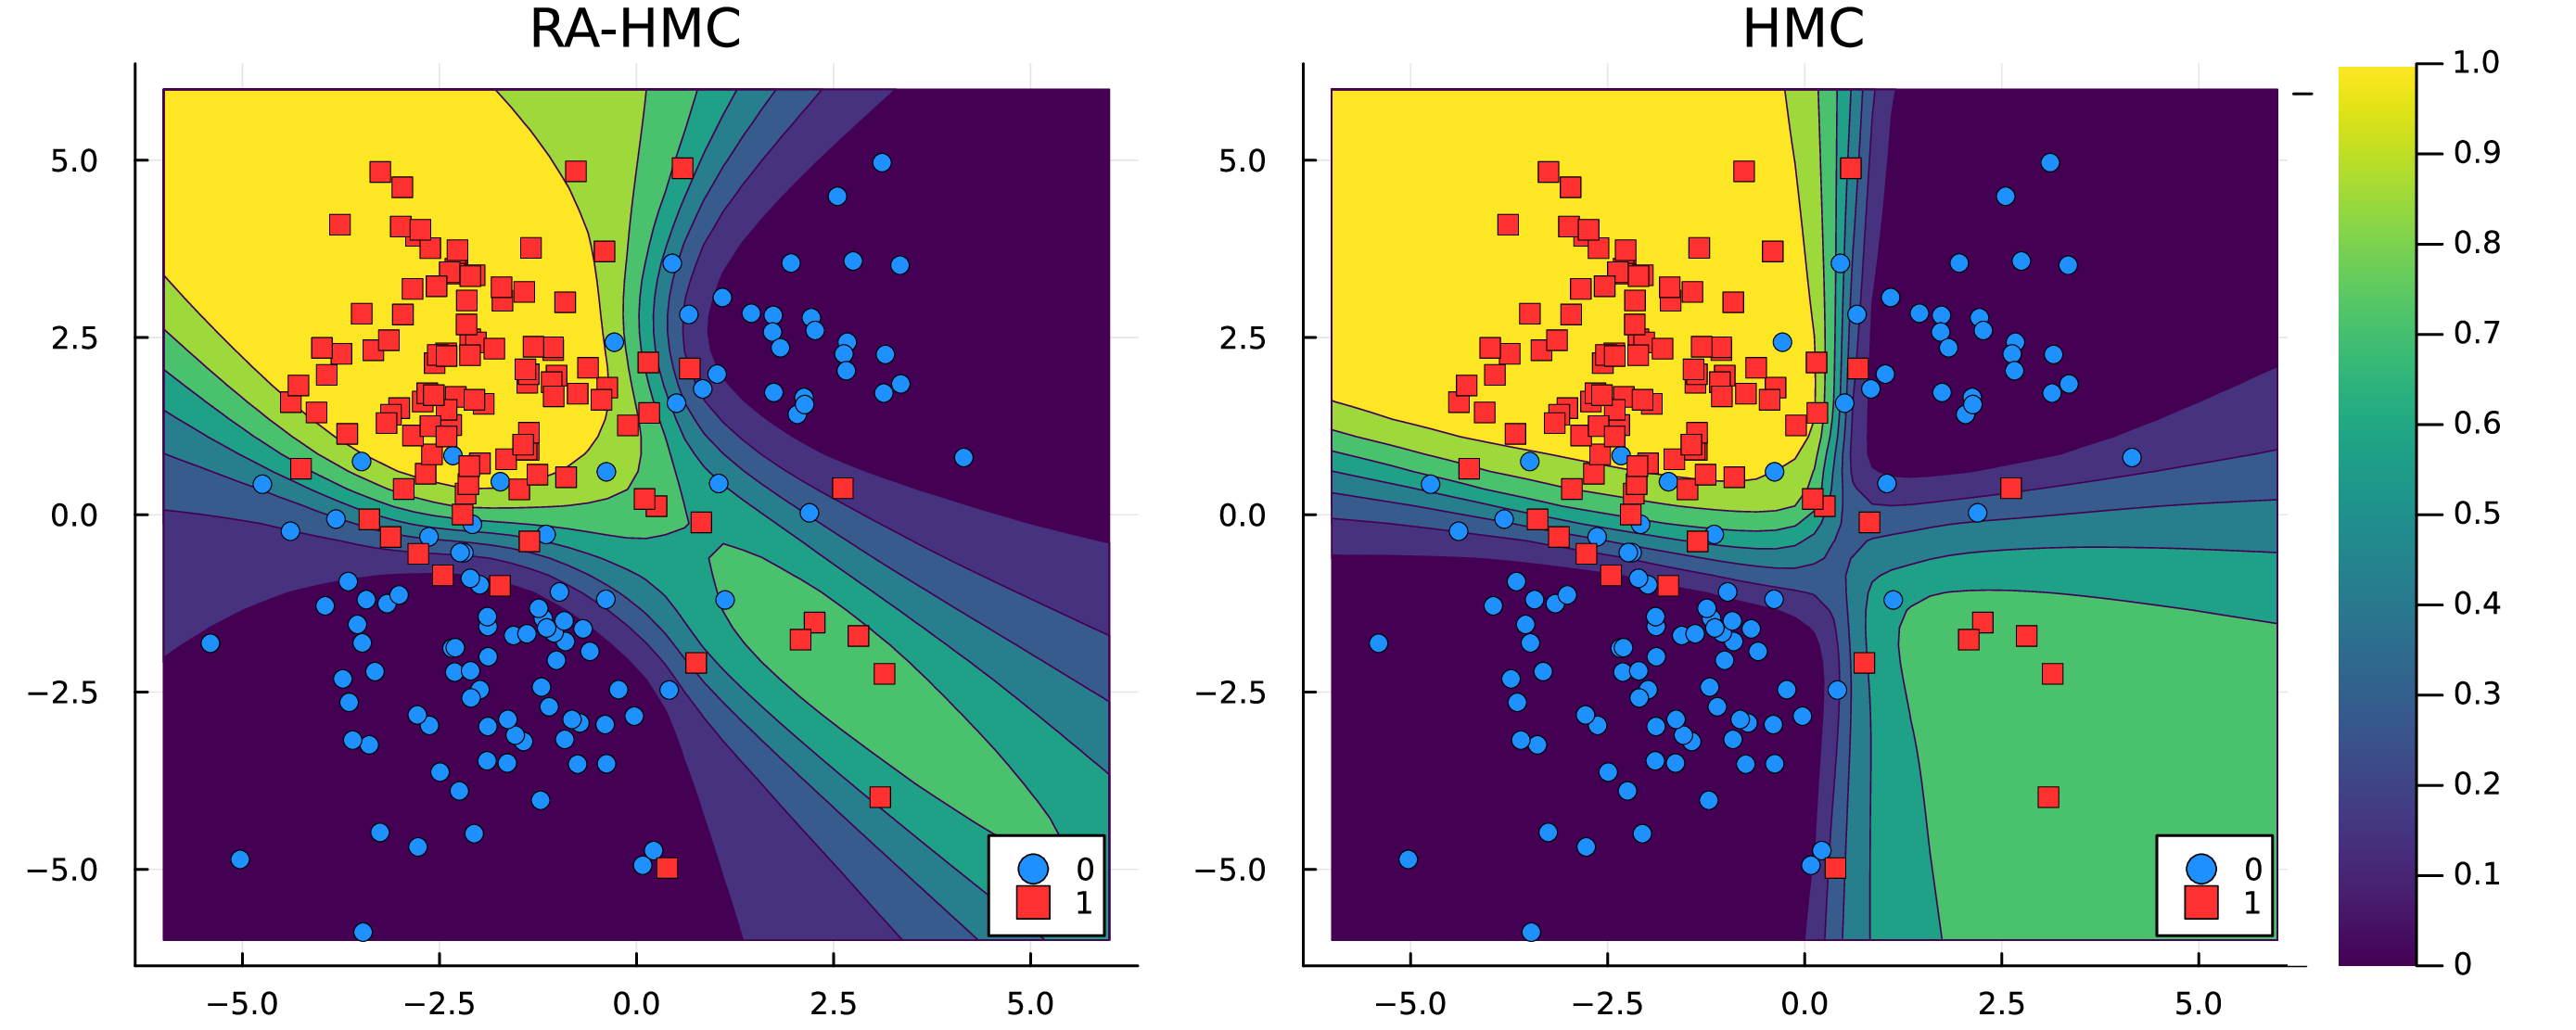
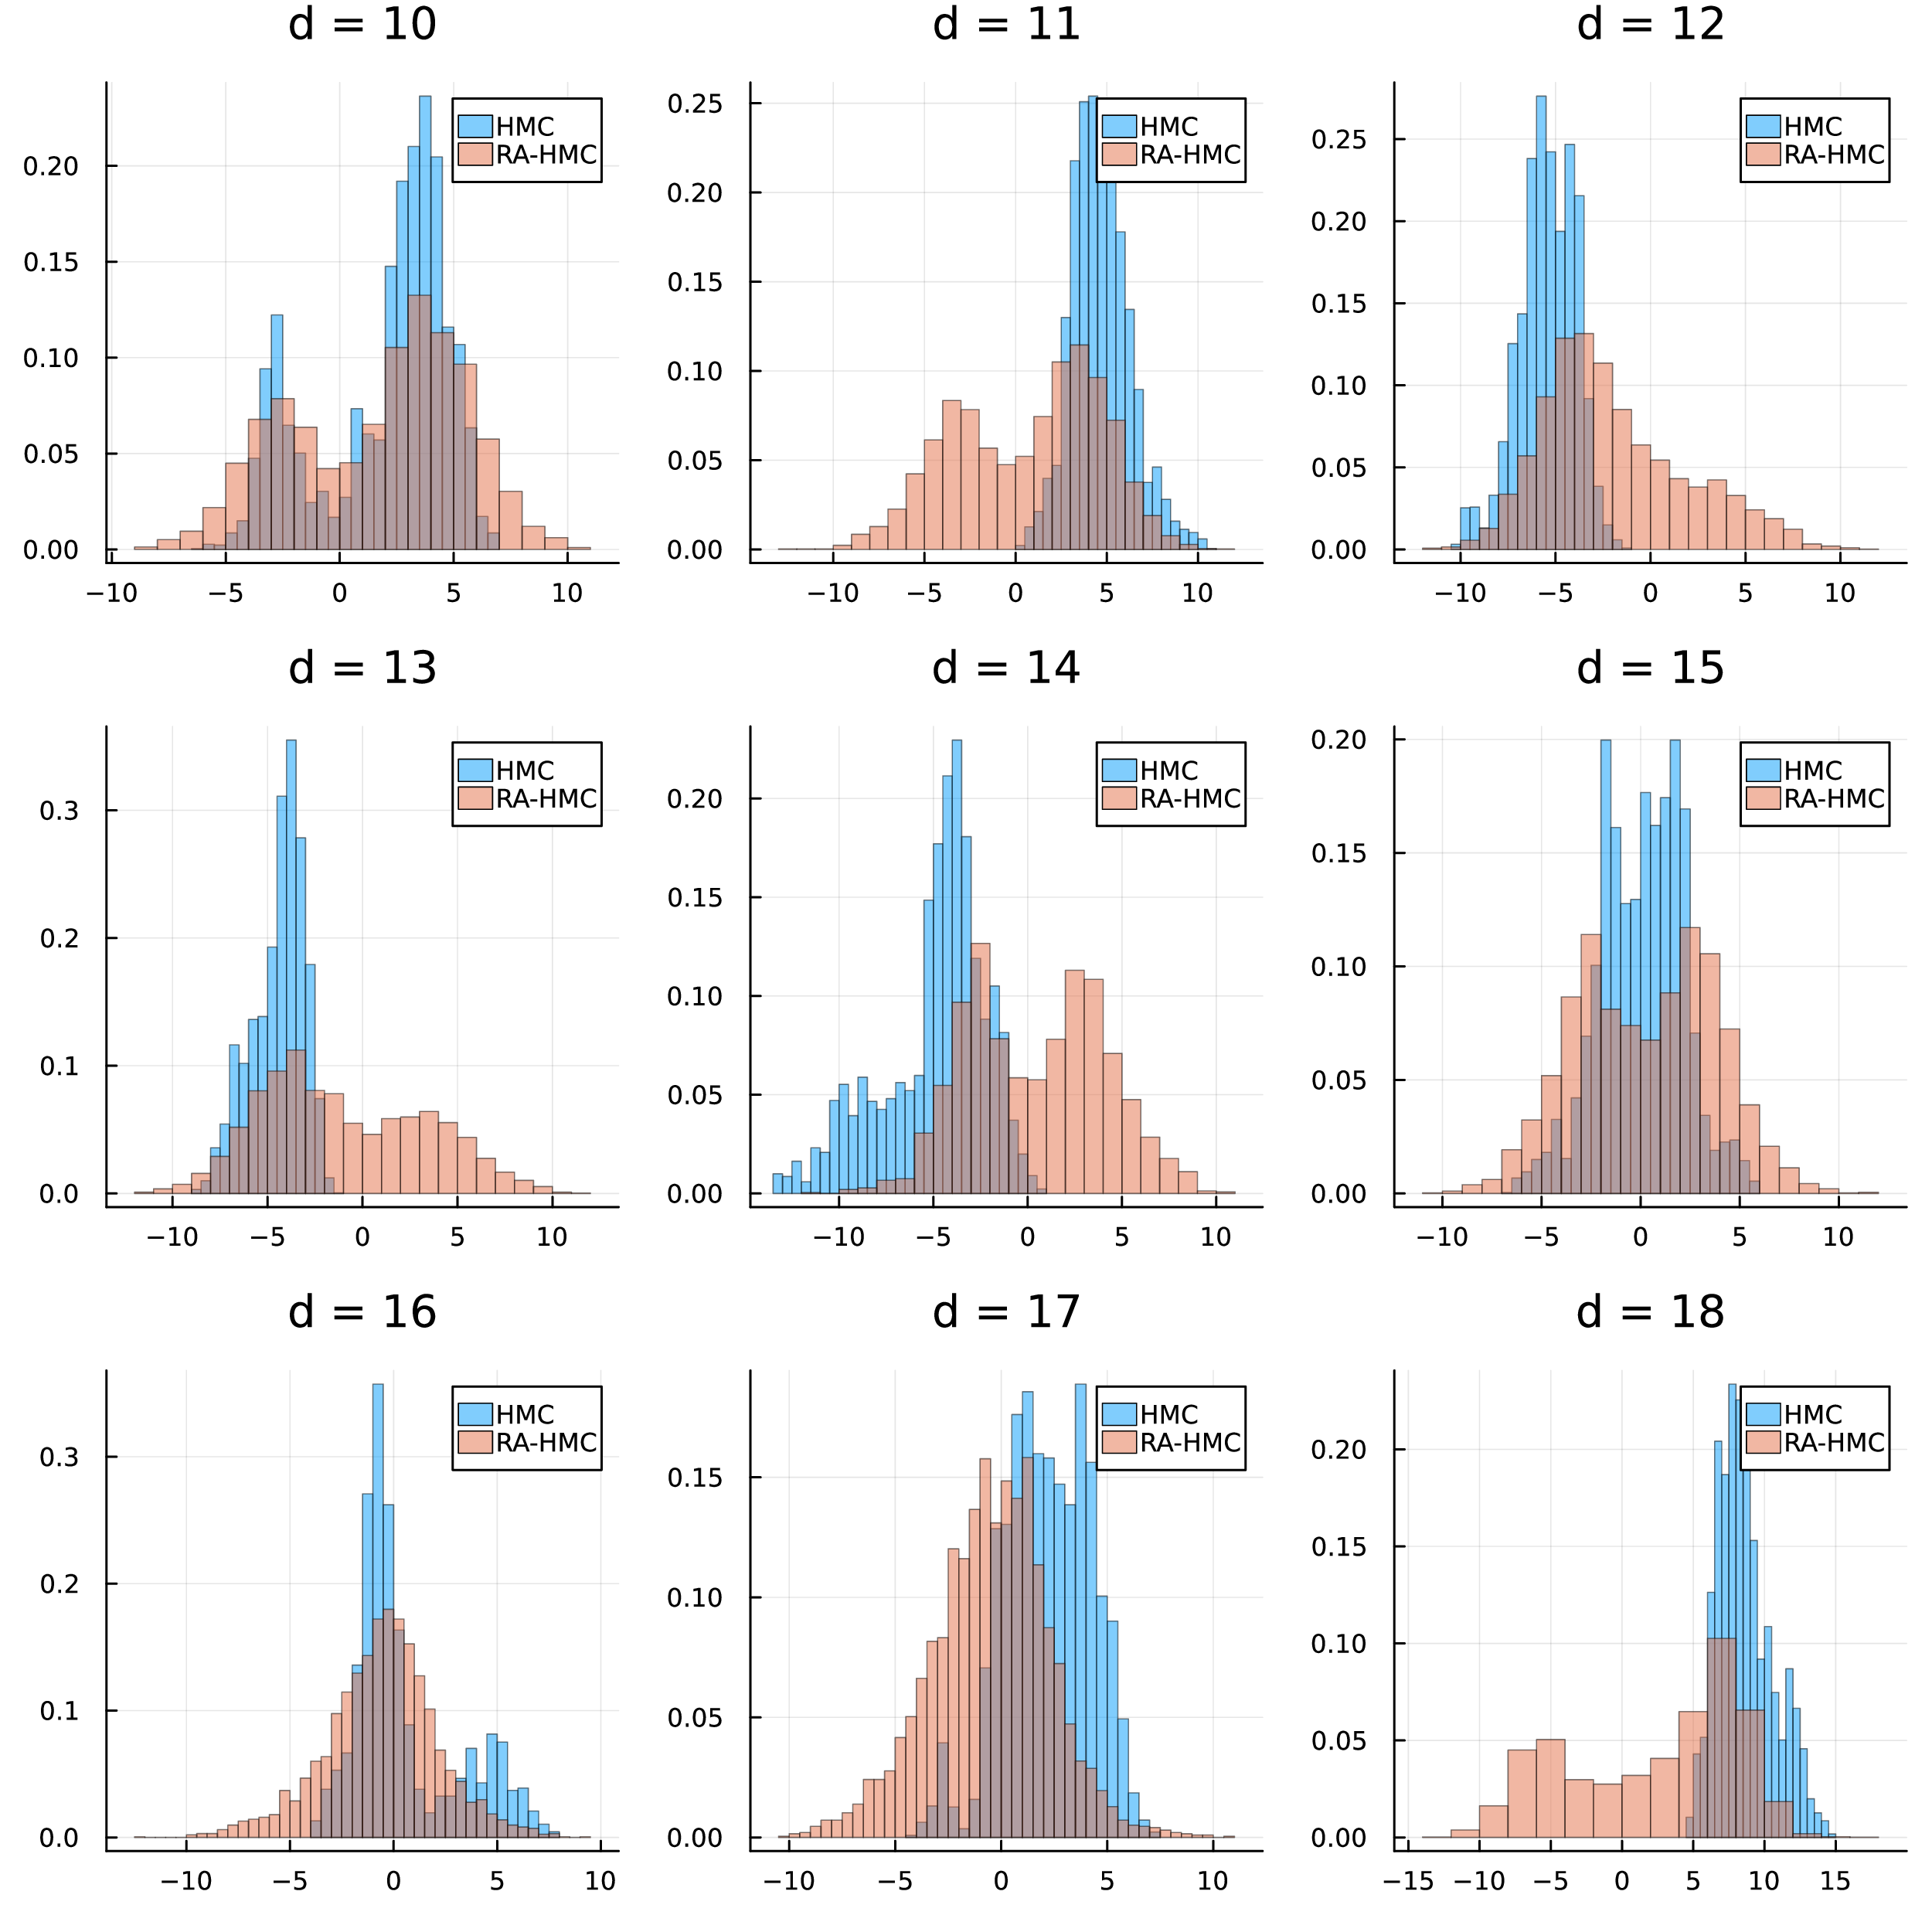
Bayesian Neural Network
Code
using main
using Distributions, DynamicPPL

x = randn(1000)
y = x .+ randn(1000) .* e

@model function lr(x, y)
    σ2 ~ Truncated(Normal(), 1e-6, Inf)
    b0 ~ Cauchy(2.0)
    b1 ~ Normal(0.0, 1.0)
    y ~ MvNormal(b0 .+ b1 .* x, σ2 * I)
end

samples, accepts = mcmc(
  DualAverage(λ=10, δ=0.8)
  HaRAM();
  lr(x, y),
  n=1e4, n_burn=1e4
);